ビジョン言語モデル、または VLMは、画像や言語を解釈し、テキスト、ラベル、座標、構造化された記述などのデジタル回答を返します。視覚言語行動モデル、すなわち VLAは、ロボットが実行できる動作に類似の入力を結びつけなければなりません。その追加の文字が、工学的問題を世界の記述から変化へと変えてしまいます。
VLMはカップを正しく識別し、それが皿の隣にあると説明することがあります。VLAは、意図したカップを選び、手の届く握り方を選び、動きを起こし、接触を監視し、物体が滑った場合に反応しなければなりません。結果はカメラのキャリブレーション、ロボットの形状、コントローラーのタイミングや安全挙動、そして意味的な理解に依存します。
この境界は絶対的なものではなく、アーキテクチャ上のものです。ロボットシステムは知覚用の VLM と行動用の別のプランナーを使い、別のモデルは端から端まで行動を生成します。すべての VLA 製品が同じ機能を持っていると仮定するのではなく、実際の入力、出力、フィードバックループでシステムを比較しましょう。
VLMはシーンに関する情報を生成します
VLMは視覚的表現と言語を組み合わせ、質問に答えたり、画像にキャプションを付けたり、物体を識別したり、空間的関係について推論したりすることができます。ロボティクスでは、これらの出力が知覚や計画を支えます。ポイント、境界領域、またはタスク記述は、他のコンポーネントにどのオブジェクトや位置が重要かを伝えることができます。
出力はロボット制御プロセスに接続されていない限り情報的なままです。物体に正しく名前を付ける際には、どのように接近するか、どのグリップポーズが安定しているか、どれくらいの速さで動くべきか、予期せぬ接触後に何をすべきかは指定されません。
VLAは、具現化されたシステムに対して動作を生成します
VLAモデルは視覚的観察や言語指示をロボットの行動にマッピングします。システムによっては、アクションはターゲットポーズ、ウェイポイント、関節コマンド、グリッパーコマンド、または動きの塊などです。アクションインターフェースは、モデルが何を学ぶべきか、何が残るかを決めます。
出力がハードウェアを動かすため、評価には物理的な結果も含まれます。レイテンシは訂正を不安定にし、小さな座標誤差で対象を見逃すことがあり、曖昧な命令が誤ったターゲットを選び込むことがあります。システムにはフィードバックと、速度を落としたり停止したり助けを求める独立した方法が必要です。
出力はスタック全体を変えます
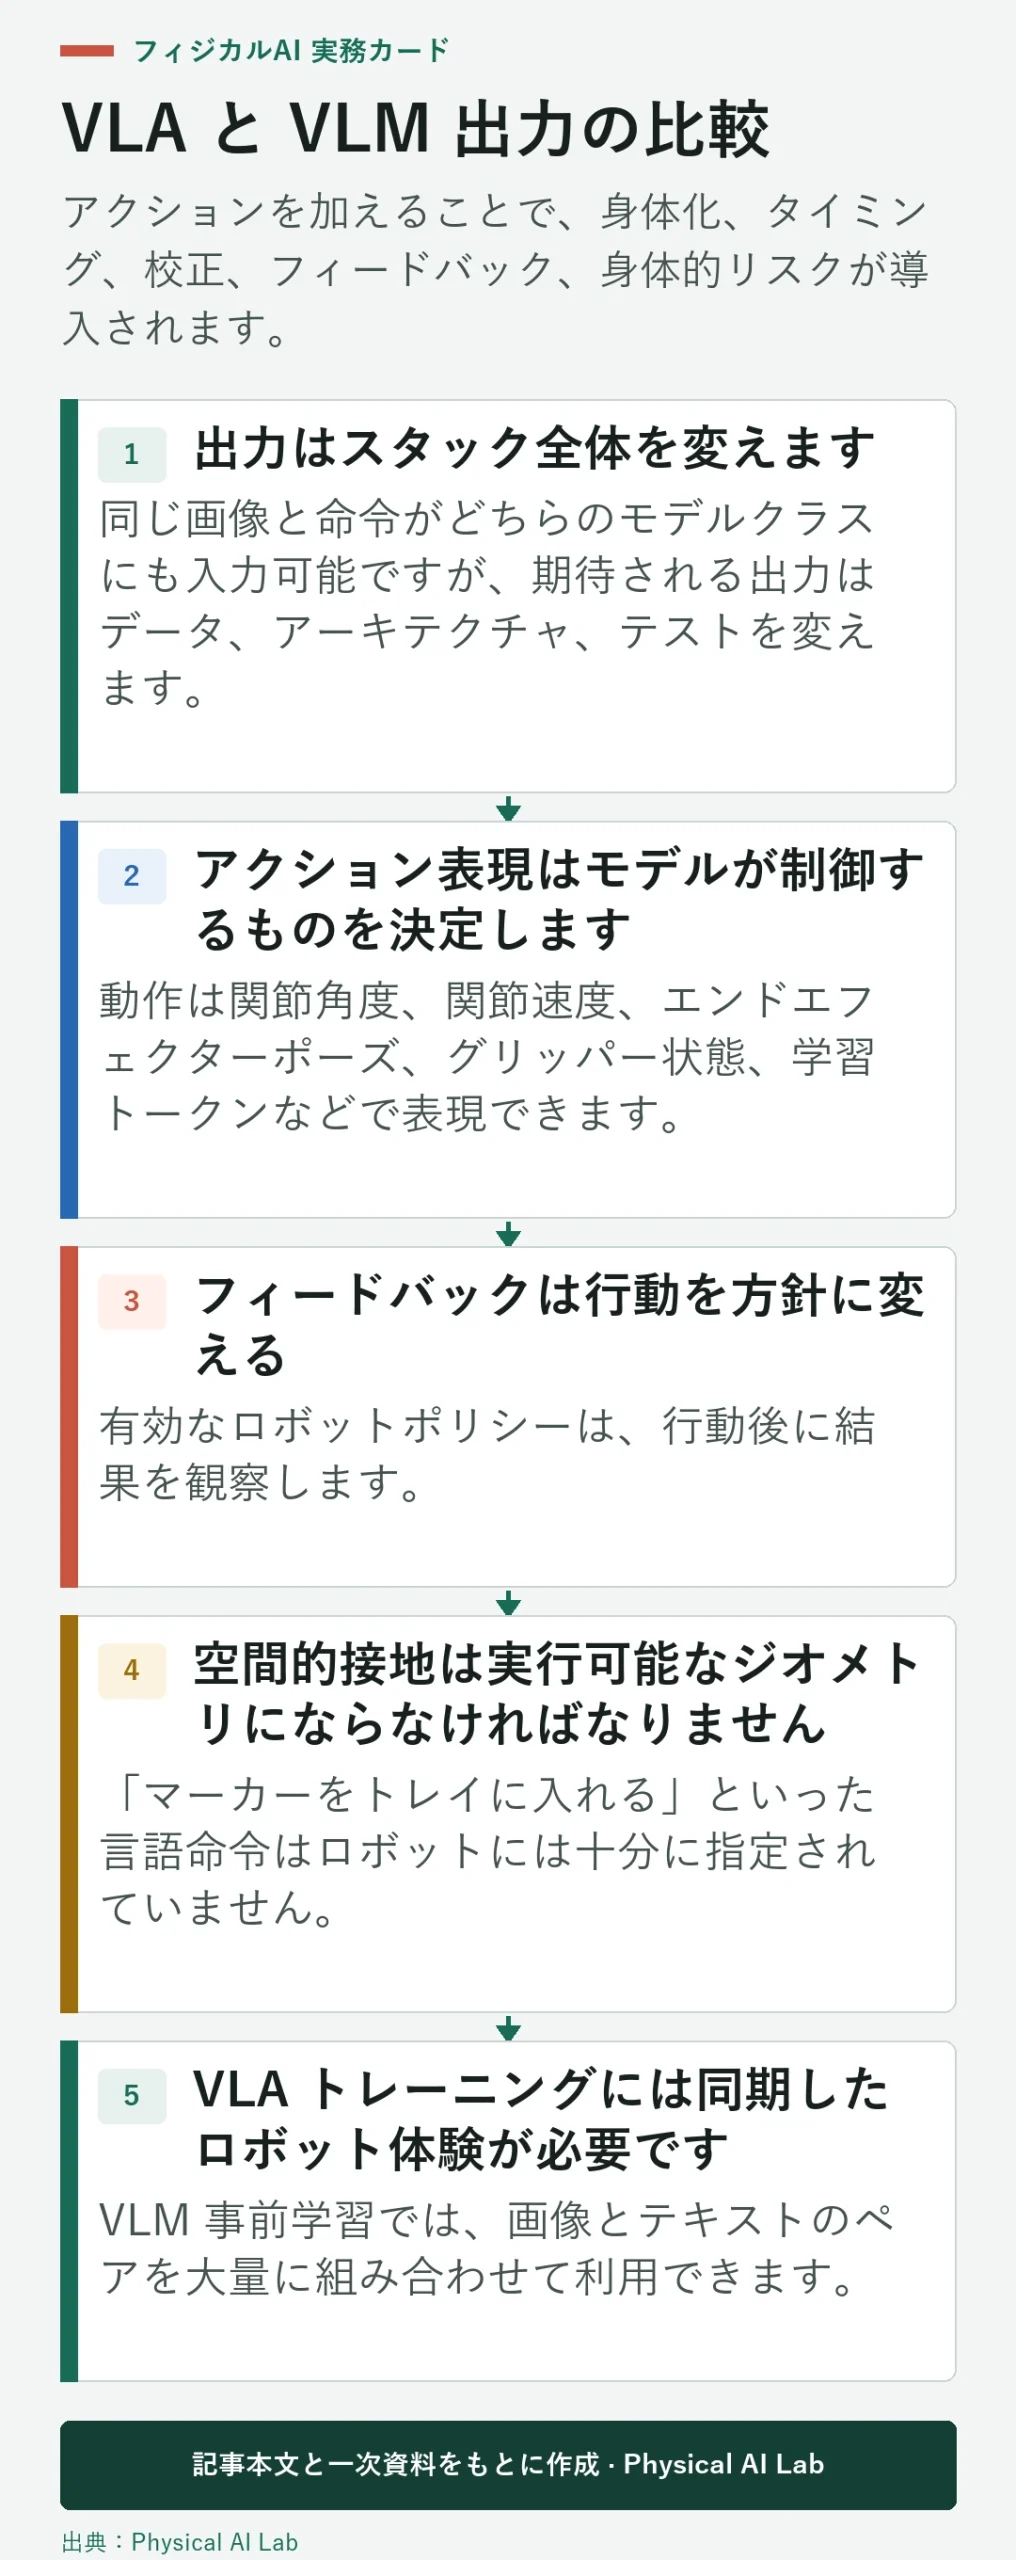
同じ画像と命令がどちらのモデルクラスにも入力可能ですが、期待される出力はデータ、アーキテクチャ、テストを変えます。 VLM は答えと照らして評価できます。同じコマンドトークンは異なる物体やキャリブレーションで異なる動きを引き起こす可能性があるため、 VLA はロボットを通じて評価する必要があります。
このカードは、シーン解釈からクローズドループアクションへの実際の移行を要約しています。また、アクションヘッドを VLM に追加するだけでは不十分であることも示しています。ロボットの状態、タイミング、身体化、回復はシステムのどこかに表現されなければなりません。
アクション表現はモデルが制御するものを決定します
動作は関節角度、関節速度、エンドエフェクターポーズ、グリッパー状態、学習トークンなどで表現できます。絶対的な目標は目的地を示し、デルタアクションは現在の状態からの変化を表します。ショートアクションチャンクは繰り返しの推論を減らすが、途中の軌道修正を遅くすることがある。
アクション空間と制御率が明示されない限り、比較は不完全です。低レートで6Dウェイポイントを生成するモデルは、高レートで関節指令を生成するモデルとは異なる形で下流コントローラーに依存します。両システムは VLA と呼ばれることもありますが、リスクやハードウェア依存度は大きく異なります。
| モデル出力 | それが象徴するもの | 下流に残るもの |
|---|---|---|
| テキストまたはラベル | 物体、関係、またはタスク記述 | 計画と制御 |
| 2次元または3次元の点 | シーンに対応づけられた目標位置 | 姿勢推定と動作生成 |
| エンドエフェクターポーズ | 望ましい工具の位置と向き | 逆運動学と関節制御 |
| ジョイントアクションチャンク | ロボット固有のコマンドの順序 | トラッキング、安全フィルタリングおよびフィードバック |
フィードバックは行動を方針に変える
有効なロボットポリシーは、行動後に結果を観察します。もしグリッパーが物体を固定せずに閉じた場合、次の観測で修正、再試行、または停止がトリガーされるはずです。オープンループ再生は固定シーンでは成功しているように見えますが、物体のポーズや接触が変わると失敗します。
フィードバックはまた、不確実性を露呈させます。システムは予想される次の状態と測定された状態を比較し、信頼度を監視し、差が大きくなったらエスカレーションします。この回復動作は、単一の成功した軌道よりも強力な展開信号となります。
空間的な対応づけを実行可能な動作へつなげる
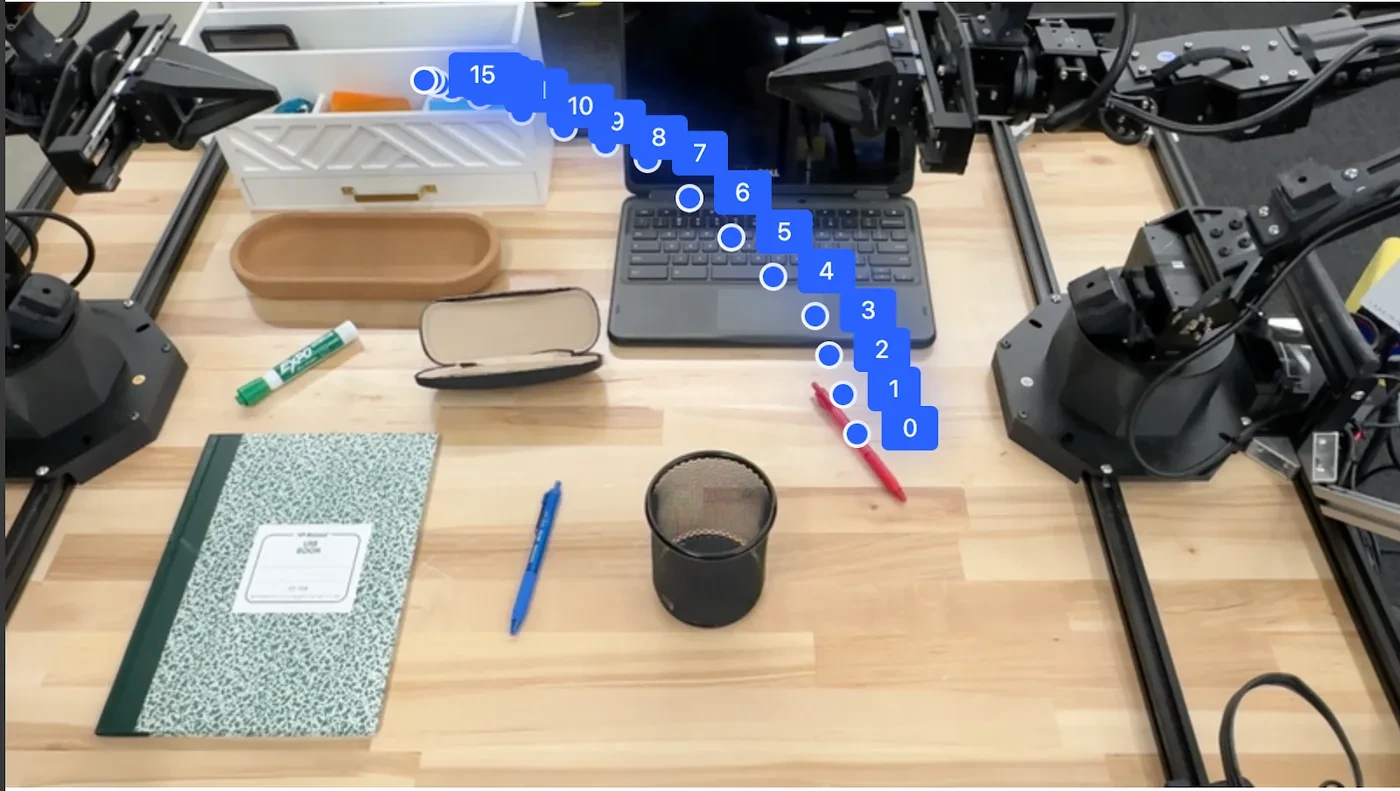
「マーカーをトレイに入れる」といった言語命令はロボットには十分に指定されていません。モデルはマーカーを特定し、掴み点を選び、障害物を考慮し、腕が届くルートを生成しなければなりません。空間的に正しい答えは機械的に不可能かもしれません。
Google Gemini Roboticsのドキュメントは、ロボットシーンに基づく空間点や軌道スタイルの出力を示しています。これらの例は、VLM型の推論と行動の間の橋渡しを示しており、実際のコントローラーとロボットが実行の質を決定します。
VLA トレーニングには同期したロボット体験が必要です
VLM 事前学習では、画像とテキストのペアを大量に組み合わせて利用できます。 VLA トレーニングには、実行可能な行動や成果に沿った観察も必要です。 ロボットアクションデータガイド は、ビデオだけでは不十分な理由を説明しています。状態、コマンド、タイミング、キャリブレーション、成功ラベルはタイムラインを共有しなければなりません。
Google DeepMindの RT-2 の研究は視覚と言語をロボットの動作に翻訳するものを扱い、 Open X-EmbodimentとRT-X は多様なロボットデータセットにわたる学習に対応しています。クロスロボットデータはスケールを拡大しますが、アクション正規化や具身メタデータの重要性も高めています。
評価は理解と実行を分けて行う必要があります
モデルは指示を理解しても、知覚ノイズや動きの制約、接触によって失敗することもあります。意味的目標の正確性は、把持の成功、タスク完了、介入とは別に報告します。これにより、変更が言語理解の向上か、それとも下流のコントローラーだけが改善されるかが明らかになります。
評価では、未見の条件も明示すべきです。新しい指示、物体、背景、ロボットの機体は、異なる種類の一般化を試します。単一の平均値ではどの層が失敗したかが隠れるため、証拠表で区別を保ってください。
| 評価層 | 指標の例 | 切り分けられる失敗 |
|---|---|---|
| 言語と対象の対応づけ | 正しい対象または領域 | 指示の誤解 |
| 行動予測 | 軌道またはコマンドエラー | 誤った動きの表現 |
| 実機での実行 | 把持とタスクの成功 | 制御、キャリブレーション、または接触の失敗 |
| 運用上の挙動 | 介入と回復率 | 例外に対処できないポリシー |
VLAはロボットシステムの一つの構成要素です
広範な ロボット基盤モデル はタスク間で VLA 挙動をサポートできますが、展開されるシステムには状態推定、コントローラ、安全機能、ログ記録、運用が必要です。これらの要素の中には習得できるものもあれば、従来型のままにできるものもあります。
このシステム観は、二つの相反する誤りを防ぎます。一つは、エンドツーエンドでないことを理由に有用なVLMを却下することです。もう一つは、VLAというラベルだけでロボット全体が自律的だとみなすことです。アーキテクチャは、図のボックスがどれだけ少ないかではなく、タスク性能と失敗の封じ込め能力で評価すべきです。
2つのロボットモデルの比較方法
各モデルの視覚入力、言語入力、ロボット状態入力、アクション表現、制御率、トレーニングデータ、対応するロボットの機体を記録します。次に実機評価を記録します:試験回数、未見の条件、介入、回復、安全性の限界。これにより、ベンダーが異なるラベルを使用していても比較可能な仕様が生まれます。
最後に、エラーの後に何が起こるのかを尋ねてください。不確実性を検出し、安全な復旧プロセスに制御を引き渡せるモデルは、ベンチマーク精度が高くエスカレーションがないモデルよりも有用かもしれません。最良の比較は、観察から行動、そして測定結果までの全ループをたどることです。
- 正確な出力を特定してください:テキスト、点、姿勢、関節アクション、またはアクションチャンクです。
- モデルに提供されたロボットの状態とキャリブレーションをリストアップしてください。
- 意味の正確さと身体的課題の成功を分けましょう。
- 介入、回復、安全事象を数えましょう。
よくある質問
VLMがロボットに取り付けられたときにVLAになるのでしょうか?
いいえ。 VLM はロボット内部で知覚や推論を提供できますが、 VLA は観察や言語をロボットが用いる行動表現に具体的に結びつけます。
VLAは常に端から端までですか?
いいえ。一部のモデルは低レベルの行動を予測し、別のモデルは下流のコントローラーが実行するウェイポイントや計画を生成します。アクションインターフェースは明示されなければなりません。
VLAはロボットを完全に自律的にするのでしょうか?
いいえ。自律性はまた、感知、制御、回復、安全、作業範囲、そして人が介入するタイミングに依存します。モデル名だけではこれらの疑問には答えが出ません。
なぜ VLA はロボット動画以上のものが必要なのでしょうか?
映像は外観や動きを表示しますが、関節の状態、コマンド、タイミング、キャリブレーション、介入は省略されることがあります。実行可能なポリシーのトレーニングには、これらのシグナルを整合させる必要があります。
VLAとVLMのパフォーマンスはどのように比較すべきでしょうか?
言語や視覚的基盤を、行動予測、身体的課題の成功、介入、回復から分離すること。彼らは一つの普遍的な指標を共有しているわけではありません。
モデル名だけでは自律性は証明されません
VLA、 VLM、ロボットの基盤モデルは広範なラベルです。能力主張を比較する前に、公開されたアーキテクチャ、アクションインターフェース、評価プロトコルおよび運用限界を確認してください。