フィジカルAIは、実際の環境を観察し、何が起きているかを推定し、行動を選択し、機械を動かし、何が変わったかを確認するシステムです。重要なのは単一のモデル名ではなく、センサー、モデル、計画、制御、安全機能と、動作結果から得られる新たな情報をつなぐクローズドループです。
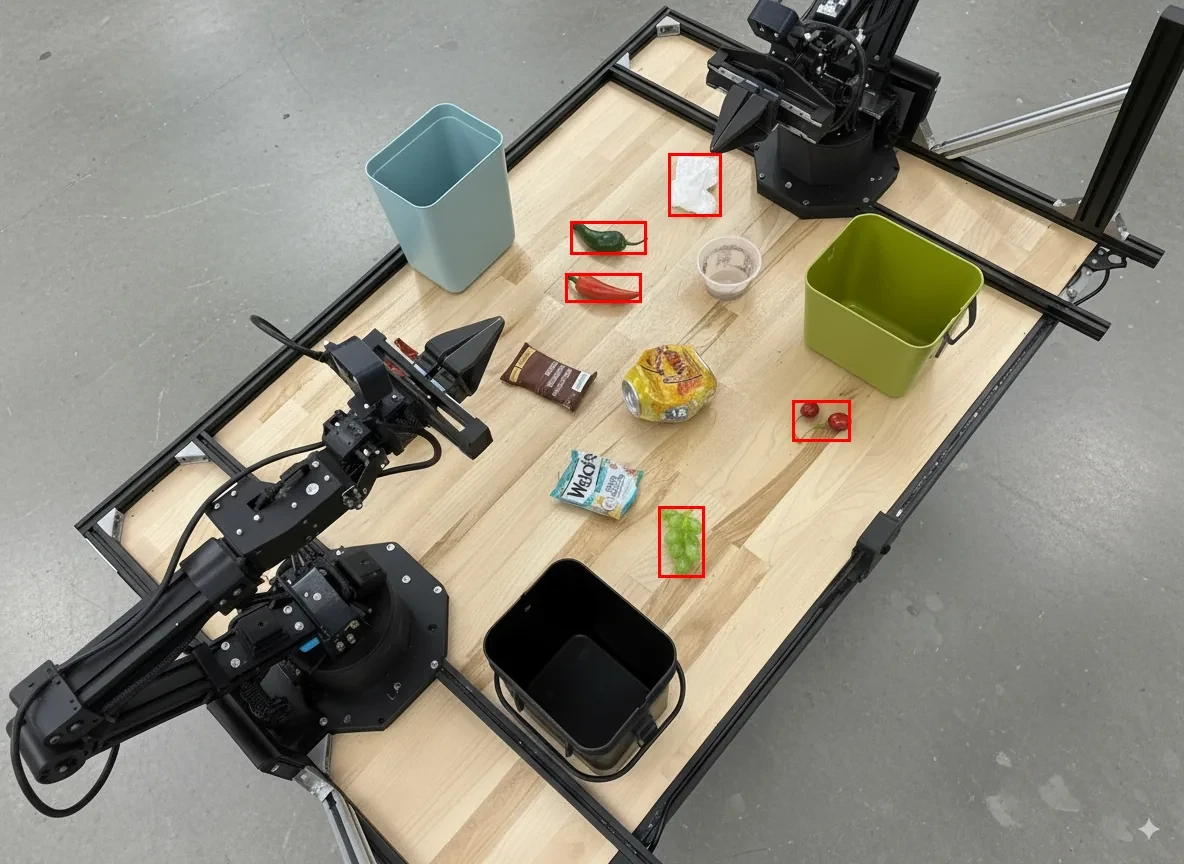
ロボットがカップを拾う様子がループを示しています。カメラや関節センサーは、周囲の状況とロボット本体の状態を捉えます。ソフトウェアはカップの姿勢、把持できる面、近くの人を推定します。プランナーがアプローチを選択し、コントローラーがアームを動かし、センサーが接触と持ち上げ、配置結果を確認します。掴みに失敗すると次の判断が変わります。
このフレームワークは、サイトの導入部分を フィジカルAIの意味、 視覚・言語・行動モデル、 ロボット行動データと結びつけています。また、流暢なモデル応答がハードウェア上の信頼性の高い動作と混同されるのを防ぎます。
「見る」とは、行動に使える状態を測定すること
カメラの画像は観測の一つに過ぎません。ロボットはRGBカメラや深度カメラ、ライダー、マイク、エンコーダー、慣性センサー、フォーストルクセンサー、触覚アレイ、安全装置を組み合わせることがあります。各センサーは、独自の範囲、解像度、遅延、ノイズ、故障モードを持つ世界の限られた部分を測定します。
行動に使える知覚では、物体の種類を識別するだけでは足りません。物体の位置、把持できる面が見えているか、ロボットがどう動いているか、どの領域を衝突から守るべきかを推定します。それらの測定値を意思決定に使うには、キャリブレーションとタイムスタンプによって共通の座標系と時間軸に揃える必要があります。
状態推定は、測定値を意思決定に使える状態表現にまとめる
センサーの読み取りは一致しないことがあり、到着間隔も異なります。状態推定はこれらをロボットや物体の姿勢、速度、接触状態、不確実性を表す推定状態にまとめます。推定結果は、現実の完全なコピーではありません。意思決定の時点で利用できる、タスクに関係する最良の推定です。
フィジカルAI向けのロボットセンサーに関するより深いガイドでは、融合と同期がなぜ重要なのかを説明しています。システムは可能な限り信頼度または共分散を保持すべきです。隠れた不確実性は危険です。なぜなら、プランナーが不確かな視覚推定を正確な幾何情報として扱ってしまう可能性があるからです。
「考える」とは、実行可能な行動を選ぶこと
ロボットの場合、推論は実行可能な行動の集合や順序を変えるときに有用です。システムは目標を特定したり、指示を解釈したり、接触結果を予測したり、把持方法を選んだり、サブタスクの順序を決めたり、安全制約に違反する目標を拒否したりすることができます。テキストでのシーン説明はまだロボットの計画ではありません。
計画は階層的になり得ます。タスクプランナーは、アイテムを取り出す前に容器を開けなければならないと判断します。モーションプランナーは衝突のないパスを見つけ、コントローラーはそのパスをジョイントコマンドに変換します。学習済みポリシーはいくつかの段階を組み合わせることもありますが、実現可能性や安全性の問題は同じまま残ります。
| 意思決定層 | 典型的な出力 | 主要な根拠 | 失敗の形 |
|---|---|---|---|
| タスク | 順序付けたサブゴール | 指示とシーン状態 | 目標を達成できない |
| 行動 | 把持または動作の候補 | 幾何学とアフォーダンス | 候補の動作では到達できない |
| モーション | 衝突のない軌道 | ロボットと障害物モデル | 有効な経路がない |
| 制御 | タイミング付きアクチュエータコマンド | フィードバックと制限 | 追跡または接触エラー |
「行動する」とは、時間制約のある制御問題
アクション予測は、ハードウェアが実行可能な動きに変換しなければなりません。ジョイントの限界、速度、トルク、ペイロード、バランス、通信速度、アクチュエーター飽和度が結果を形作ります。抽象モデルで有効なコマンドであっても、ロボットでは安全でなかったり動的に不可能な場合があります。
高速なフィードバック制御は、大規模AIモデルより下位の制御層で独立して実行されるのが一般的です。リアルタイムコントローラーは位置、速度、トルク、力を追跡し、安全ロジックは制限や保護装置を監視します。この層状設計により、緊急時の対応をすべて生成モデルに委ねることなく、より遅い意味論的推論で作業を導くことができます。
フィードバックはフィジカルAIループを閉じる
ロボットは行動した後に実際に何が起こったのかを観察しなければなりません。グリッパーは意図した物体に接触しましたか?物体は手とともに動いたのでしょうか?物体を所定の場所に置けたか?作業領域に人が入っていないか?検証は成功、再挑戦、回復、または安全な停止の証拠を作り出します。
オープンループのデモンストレーションでは、クリップがもっともらしい動きの後に終わるため、この要件を隠すことができます。本番システムは明確な成功条件とタイムアウトを必要とします。観測値が予測結果と異なる場合、システムは偽りの仮定から続けるのではなく、状態を更新すべきです。
安全は最終点検ではなく、すべての段階に制約をもたらします
安全はセンシング範囲から始まり、不確実性の取り扱い、計画制約、制御限界、監視付き停止を経て続きます。モデルが検証されたエンベロープの外で任意のアクチュエータコマンドを発行することは許されません。人が機械に近づける場合には、独立した保護機能が必要になることがあります。
ロボットの動作領域、許可された接触、最大力、フォールバック状態、再起動の責任を定義します。不確実性は行動を変えるべきです。機械は速度を落としたり、別のビューを要求したり、助けを求めたり、停止したりすることができます。信頼度が速度低下や再観測、停止などの行動変更に結びつかないのであれば、表示上の数値にすぎません。
学習は完全なエピソードと失敗に依存しています
ロボット学習データは、観察、状態、行動、タイミング、結果を整合させるべきです。成功したエピソードは有用な行動を教え、失敗データは、遮蔽や不適切なキャリブレーション、接触の不安定性、回復状態を明らかにします。すべての失敗した試みを削除すると、ポリシーがいつ停止すべきか、いつ修正すべきかを教えないデータセットが生まれてしまうことがあります。
デモンストレーションデータは、遠隔操作、スクリプト制御、シミュレーション、または自律試験から得られることがあります。 テレオペレーションデータガイド は、同期やキュレーションがエピソード数と同じくらい重要な理由を示しています。運用ログから、どの状態のデータを追加収集すべきかを判断できます。
| ループ信号 | 記録するもの | なぜ重要なのか |
|---|---|---|
| 観察 | センサーストリームとキャリブレーション | ポリシーが利用できた情報を再現できる |
| 状態 | ロボットのポーズ、関節、接触 | 知覚結果と機体の状態を分けられる |
| 行動 | コマンドと実行時刻 | 意図と実際の動作を結びつける |
| 結果 | 成功、失敗、そして介入 | 評価と回復学習を支援する |
| コンテキスト | タスク、オブジェクト、環境 | データのカバレッジと分布シフトを把握できる |
レイテンシは、ロボットが安全に行える動作を制約する
知覚の結果は、コントローラーに到達するまでの過去を記述します。カメラ露出、転送、前処理、推論、計画、通信はそれぞれ遅延をもたらします。人や物体が動くと、ロボットはすでに古くなった状態を基に、たとえすべてのモデルが個別に正確であっても行動することがあります。
オンボード推論は、 Edge AI for robotsガイドで説明されているように、時間に敏感な機能のループを短縮できます。モデルの推論時間だけでなく、情報の取得から制御までの経過時間とジッターを測定します。最も遅い処理経路と観測された最大遅延は、安全側の動作速度を判断する際の重要な入力になります。
有用な評価は完全なループを検証します
オフラインモデルの精度がタスクの成功を証明するわけではありません。代表的な物体、人、照明、表面状態、開始状態を含む実機試験を繰り返し、結果を評価します。初回成功、最終成功、介入、完了時間、安全イベント、試験でカバーしたタスク分布の範囲を報告してください。
アブレーション試験はボトルネックを特定するのに役立ちます。知覚をグラウンドトゥルース状態に置き換えたり、学習したポリシーをスクリプト化された計画に置き換えたり、新しいモデルで記録されたセンサーデータを再生したりします。これらの比較は、次の改善がセンシング、推論、計画、制御、または運用のいずれかにあるかを示しています。
ロボットのデモは演出ではなく、証拠として読む
強力なデモンストレーションは、課題の境界、試験回数、人的関与、速度、環境変化、故障処理などを明示します。編集された1回の成功例は能力の存在を示すことはできますが、信頼性や自律性、対応範囲を確立することはできません。最初の予期せぬ出来事の後もループは動作し続けなければなりません。
公表された主張を検証する際は、サイトの ヒューマノイドビデオ評価ガイド と テレオペレーション・チェックリスト を活用してください。自然に見える動きだけを判断するのではなく、連続した映像、独立したタスク検証、開示された介入を探しましょう。
- タスクと成功条件を定義してください。
- すべての観測と制御入力を特定しましょう。
- エンドツーエンドの遅延と不確実性を測定してください。
- 再試行、介入、失敗を記録します。
- 代表的な繰り返し試験で結果を検証します。
よくある質問
見る・考える・行動するループはAIモデルの一つなのでしょうか?
いいえ。これは、学習済みモデル、状態推定、プランナー、コントローラー、安全機能、ハードウェアを組み合わせたシステムパターンです。一部のモデルは複数の段階を接続しますが、物理的なインターフェースは残っています。
ロボットはフィジカルAIであるために VLA モデルが必要ですか?
いいえ。ロボットは従来のビジョン、ルール、計画、フィードバック制御で知覚と行動のループを閉じることができます。 VLA は観察や言語を行動に結びつけるための一つのアーキテクチャです。
なぜ行動後にフィードバックが必要なのでしょうか?
物理的な実行は、接触、滑り、障害、校正誤差、環境の変化などによりコマンドと異なる場合があります。フィードバックは成功を確認し、再試行、リカバリー、停止のどれを選ぶかを決める根拠になります。
安全ロジックはどこに配置すべきでしょうか?
安全は層が重なっています。タスクポリシーは制約を尊重でき、時間的に重要な保護機能や認証デバイスは高水準のAIモデルとは独立して動作することもあります。
ループの最適な指標は何ですか?
タスクレベルの成功率に加え、評価範囲、完了時間、介入回数、安全上のイベント、リカバリー動作を指標として使います。段階レベルの指標を追加して、ループ全体が成功または失敗する理由を診断します。
工学的証拠に関する注意事項
フィジカルAIアーキテクチャやモデルの能力は急速に変化します。現在のドキュメントを確認し、代表的なハードウェア、環境、安全条件に関する完全なセンシングからアクションへのループを評価します。