ヒューマン・イン・ザ・ループの介入データは、人が自律実行を監視し、困難または危険な状態の近くで制御を引き継ぎ、軌道を修正し、必要に応じて制御をポリシーへ戻す過程で得られます。これは、最初から人間が操作するオフラインの遠隔操作デモンストレーションとは異なります。
その価値は、ポリシーが到達した状態と回復の文脈にあります。制御引き継ぎ前の観測、制御権限、人間の行動、介入理由、ハンドバックの判断、その後の自律実行の結果を、一つの連続したタイムラインに記録する必要があります。
このガイドは テレオペレーションデータガイド および ロボット評価ガイドと併用してください。職業安全および機械安全管理は学習ループから独立して管理しましょう。
完全なデモンストレーションとは別の介入
デモンストレーションでは、人間のオペレーターが選んだ状態がサンプルになります。介入では、オペレーターが支援が必要だと判断する前にポリシーが到達した状態がサンプルになります。これらの分布は異なる学習上の問いに対応するため、異なるラベルを付けるべきです。
修正の前後の自律動作も保持してください。取り除くと、人間が操作した映像だけが切り離され、制御引き継ぎが必要になった原因やハンドバックの成否を示す証拠が失われます。

制御権限をステートマシンとして定義する
状態の例には、自律実行、警告、制御引き継ぎ要求、人間による制御、ハンドバック要求、自律復帰確認、緊急停止があります。ボタン信号の変化だけでは、ロボットが要求を受理したか、どのコマンドがアクチュエーターに届いたかは分かりません。
ポリシーやオペレーター提案だけでなく、裁定の出力とアクチュエーターコマンドをログにまとめてください。ネットワーク損失、デッドマンスイッチ、またはセーフティコントローラが要求されたモードと競合した場合の優先度を定義します。
| フェーズ | 必要記録 | 主な質問 | 故障リスク |
|---|---|---|---|
| 自律 | ポリシーの観測と行動 | 何が問題につながったか? | 前兆の欠落 |
| 制御引き継ぎ | 要求時刻と実効制御開始時刻 | 権限移譲はどれだけ遅れたか? | レイテンシ |
| 修正 | 人間の行動と意図 | どの回復を試みたか? | ラベルの曖昧さ |
| ハンドバック | ゲート判定と状態信頼度 | ポリシーが今この状態を扱えるか? | すぐに再介入 |
| 結果 | タスク、安全、介入の結果 | 回復は成功したか? | 成功例だけの選別 |
介入前の文脈を保持する
数秒間またはタスク関連の期間をバッファしてから引き継ぎ、データセットに前兆の手がかり、ポリシーアクション、進捗損失を含めるようにしましょう。正しいウィンドウは固定されたフレーム数ではなく、タスクのダイナミクスやアクションホライズンに依存します。
同期したビデオ、ロボットの状態、コマンド、フォース、モード、イベントタイムを保存します。人間の判断は、モデル入力に現在含まれていない証拠に依存することがあります。
意思決定レイテンシとシステムの制御引き継ぎレイテンシを測定する
オペレーターが状況を知覚して判断するまでの時間と、インターフェース、ネットワーク、仲裁、コントローラーの遅延は分けて測定します。実機はどちらの時間にも大きく動き得るため、人が実際に制御を受け取る時点の状態が変わります。
要求、確認応答、最初に実際の制御に使われた人間のコマンド、測定可能な応答を記録します。ボタンを押した瞬間に修正が始まったと仮定せず、実際に遅延が経過した後の状態を学習に使ってください。
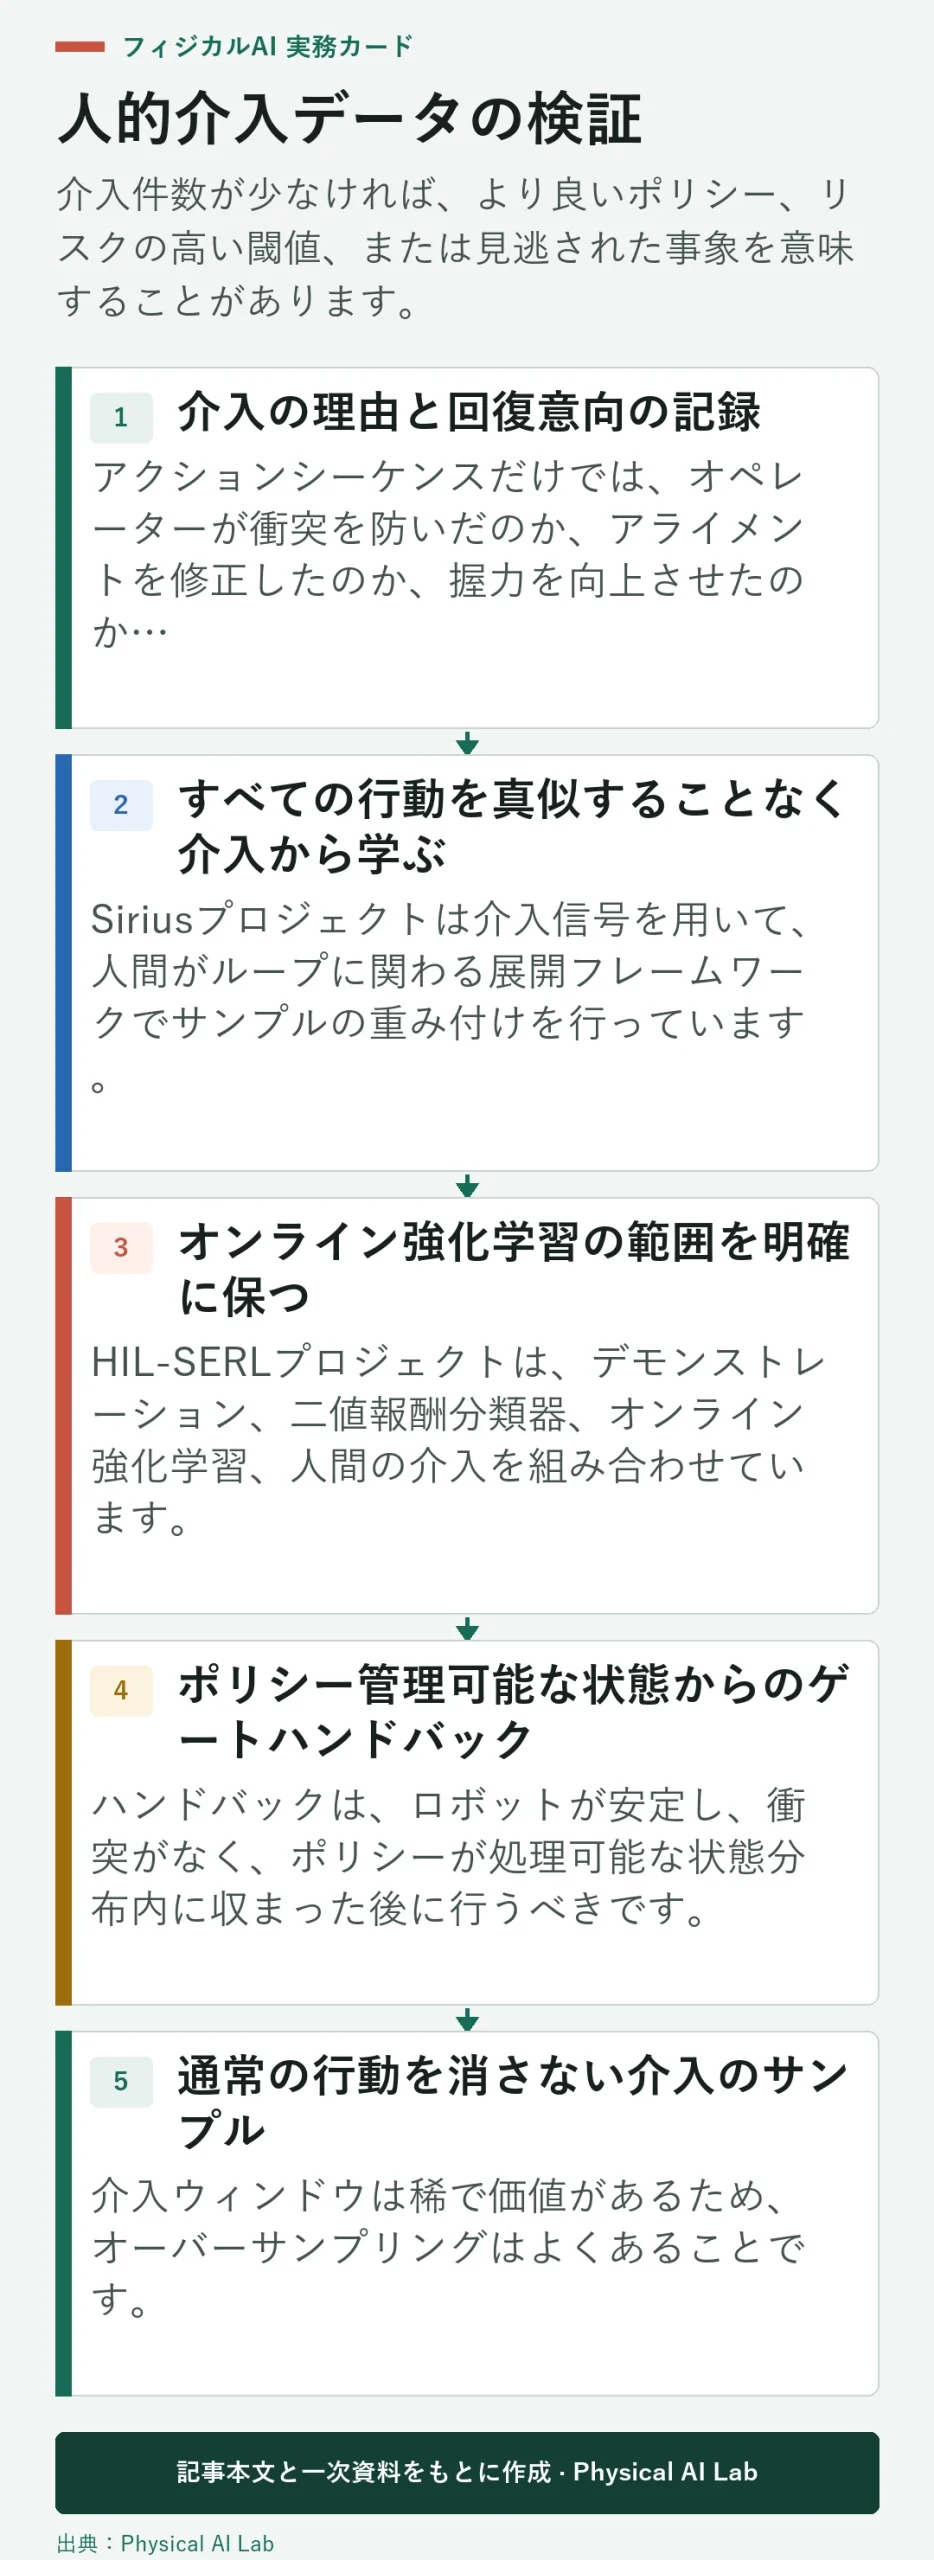
介入の理由と回復意向の記録
アクションシーケンスだけでは、オペレーターが衝突を防いだのか、アライメントを修正したのか、把持を改善したのか、不確実性に対応したのかを説明することはほとんどありません。制御された理由の分類法に加え、オプションの注釈や信頼を活用しましょう。
理由はフィルタリングと評価を支持しますが、検証された根本原因とは分けておきましょう。オペレーターの判断はシフトごとに不完全または一貫性がない場合もあります。
すべての行動を真似することなく介入から学ぶ
Siriusプロジェクトは介入信号を用いて、人間がループに関わる展開フレームワークでサンプルの重み付けを行っています。その結果、報告されたタスクとハードウェアを備えた特定の研究方法が生まれ、すべての介入フレームに最大限の重みを置くという一般的なルールではありません。
マッチングデータの下で行動クローン、介入の重み付け、その他の更新情報を比較します。人間の修正は、テレオペレーションインターフェースによって遅延したり、最適でなかったり、制約されたりすることがあります。
オンライン強化学習の範囲を明確に保つ
HIL-SERLプロジェクトは、デモンストレーション、二値報酬分類器、オンライン強化学習、人間の介入を組み合わせています。プロジェクトページには、報告された操作タスクごとにポリシーが改善されるにつれて介入を減らす方法が説明されています。
報酬例、デモンストレーションバッファ、介入、自律的経験を一つのラベルのないデータセットにまとめてはいけません。役割や選択バイアスは異なります。
ポリシーが扱える状態か確認して制御を戻す
ハンドバックは、ロボットが安定し、衝突のない状態で、ポリシーが処理できる状態分布に戻った後に行うべきです。オペレーターが動きを止めたという理由だけで制御を戻してはいけません。そうすると、接触や位置ずれが未解決のまま自律実行が再開される可能性があります。
確認応答を必要とし、自律制御へ戻った直後の動作区間を監視してください。状態遷移の履歴を残したまま、必要なら人間がすぐに制御を再び引き継げるようにします。
通常の行動を消さない介入のサンプル
介入ウィンドウは稀で価値があるため、オーバーサンプリングはよくあることです。過剰な重み付けは、通常状態中の回復動作を模倣したり、ある運用者の習慣を過剰に調整したりすることがあります。
データセット混合ガイドを使って、正常な自律的、成功した回復例、そしてハードネガティブ例を保持しましょう。フェーズごとに効果的な曝露を報告してください。
介入数以上の評価
介入が少ない理由は、自律性の向上だけとは限りません。オペレーターが介入を控えた場合、危険を見逃した場合、タスクが早期終了した場合にも件数は減ります。自律成功率、危険事象、作業負荷、判断レイテンシ、修正時間、再発率、タスク品質を併せて報告します。
隠れた支援なしで固定ポリシーの独立評価を実施しましょう。コレクターの安全支援と、ポリシーの測定された自律能力を分離してください。
モードオーバーレイ付きの完結エピソードをレビュー
ビデオ、状態、ポリシーの動作、人間の動作、実際に使われたコマンド、制御権限を同じ時間軸で再生してください。切り替え境界の時刻整合、欠落パケット、オペレーターが制御引き継ぎを意図したのにロボットが別の理由で停止した事例を点検します。
成功した回復例だけでなく、介入のなかったエピソードや不要だった制御引き継ぎの例も抽出して確認します。オペレーターのデータについて、プライバシーと労務上の管理を維持してください。
| 指標 | 測定対象 | 必要な分母 | 誤解を招く近道 |
|---|---|---|---|
| 介入率 | オペレーターの作業負荷 | 対象となる全展開 | 生の件数だけ |
| 制御引き継ぎレイテンシ | 制御権限の移譲 | 引き継ぎ要求イベント | ボタンのタイムスタンプだけ |
| 修正成功率 | 直後の回復 | 完了した介入 | 見栄えのよいクリップだけ |
| 再発率 | ハンドバックの品質 | 自律制御への復帰 | 最初の安全なフレームだけ |
| 自律成功率 | ポリシーの能力 | 固定プロトコルでの試行 | 介助付きの完了 |
介入データ仕様を添えてリリースする
制御権限の状態、介入を起動する条件、レイテンシ、観測バッファ、アクションチャネル、理由分類、ハンドバックの判定条件、安全制御、サンプリング方法、評価プロトコルを文書化します。各学習例を、元の連続した実行記録に対応づけてください。
以下のチェックリストで検証を締めくくります。
- 人間が制御を引き継ぐ前の自律実行の文脈を記録します。
- 実際の制御権の移行と物理応答を測定します。
- 修正理由、目標、結果を保存してください。
- ポリシーが扱える状態か確認してから制御を戻します。
- 自律性、安全性、学習成果を別々に評価しましょう。
よくある質問
介入データは遠隔操作のデモンストレーションデータと同じですか?
いいえ。介入データは、人間がポリシーに修正が必要だと判断した状態の前後を含む、自律実行中の記録です。
介入のわずかな数秒だけを保存すればよいですか?
いいえ。前兆、引き継ぎ、修正、返却、そしてその後の結果を一つの同期されたエピソードタイムラインに保持します。
介入回数が減ることは改善を証明するのでしょうか?
いいえ。固定プロトコルの自律性、安全性、ワークロード、ミスイベント指標と組み合わせましょう。
すべての人間の行動を正解データとして扱うべきですか?
いいえ。人間の修正は遅延したり、インターフェースに制限されたり、最適でない場合があり、文脈に応じたラベルや評価が必要です。
いつポリシーに制御を戻すべきですか?
明示的なゲートが、ポリシーで管理できる安定した状態だと確認し、ハンドバックが受理された場合にのみ制御を戻します。
制御権限と自律的なハンドバック境界
介入データは、訓練サンプルであると同時に、制御権限の移り変わりを追跡する記録でもあります。制御引き継ぎを必要とした状態と、自律制御へのハンドバックが安全だったことを示す証拠を保存します。