机器人奖励模型将人类判断、演示或视频进展转换为状态、动作或轨迹段的评分。当手写奖励缺少流畅性、关怀、可接受的恢复或指令遵循性等特质时,这种模型非常有用,但学习到的分数仍作为反馈过程的代理。
核心风险在于用户评审的示例之外的优化。模型可以很好地预测长期比较,同时仍然奖励与标签数据中偏好片段相关的摄像头捷径、重复、长轨迹或不安全行为。
将本指南与 人类干预数据指南 及 机器人 VLA 评估指南一起使用。将任务成功、安全约束和独立的人类判断排除在奖励模型之外。
具体定义奖励模型的预测
选择输出代表的是两两偏好、标量质量、目标进展、成功概率还是未来事件估计。标注该标签后方的观察窗口、动作上下文、预测视野和评估者群体。
不要将舒适度、速度、安全和任务完成合并为一个未公开的评分。当操作员可能在不同部署中以不同方式交换尺寸时,应分别保留尺寸。

选择与问题匹配的反馈格式
成对比较则询问两个片段中哪个更好,通常能减少评级者之间的尺度差异。评分表达大小,但需要锚点。进展标签可以提供时间密度,但假设任务单调地朝目标推进。
成功标签回答了一个更狭窄的终点问题。从运营决策中选择格式,记录平局、糟糕案例和无法判断结果,而非强制任意获胜者。
| 反馈 | 答案 | 实力 | 主要风险 |
|---|---|---|---|
| 成对 | 哪种更受欢迎 | 简单相对判断 | 没有绝对的质量 |
| 分级 | 真棒 | 可用星等 | 雷特尺度漂移 |
| 进展 | 更接近球门 | 密集时间信号 | 非单调任务 |
| 成功 | 目标达成 | 终点清晰 | 稀疏狭窄 |
| 更正 | 应该改变什么 | 可操作的上下文 | 教师与控制偏差 |
制定基于可观测证据的标注评分标准
定义任务目标、禁止行为、平滑性或效率标准、平局条件和不可观察因素。包含目标机器人的正面、负面和边界示例,而非依赖“良好”或“安全”等词汇。
视频评定员无法推断力、转矩、延迟、摄像机外碰撞或控制器限制是否触发,除非界面暴露这些证据。应标记缺失信息,而非让外观成为替代。
保留注释者身份和分歧
按任务和失败类别衡量评级者间的共识,但不应抹去合理的偏好差异。操作员、安全审查员和终端用户可能因职责和信息不同而重视不同的行为。
在每个评判中保存评级员培训、评分标准版本、时间戳和信心。重新裁定系统性分歧,报告子群体行为,而不是将所有标签合并为多数票。
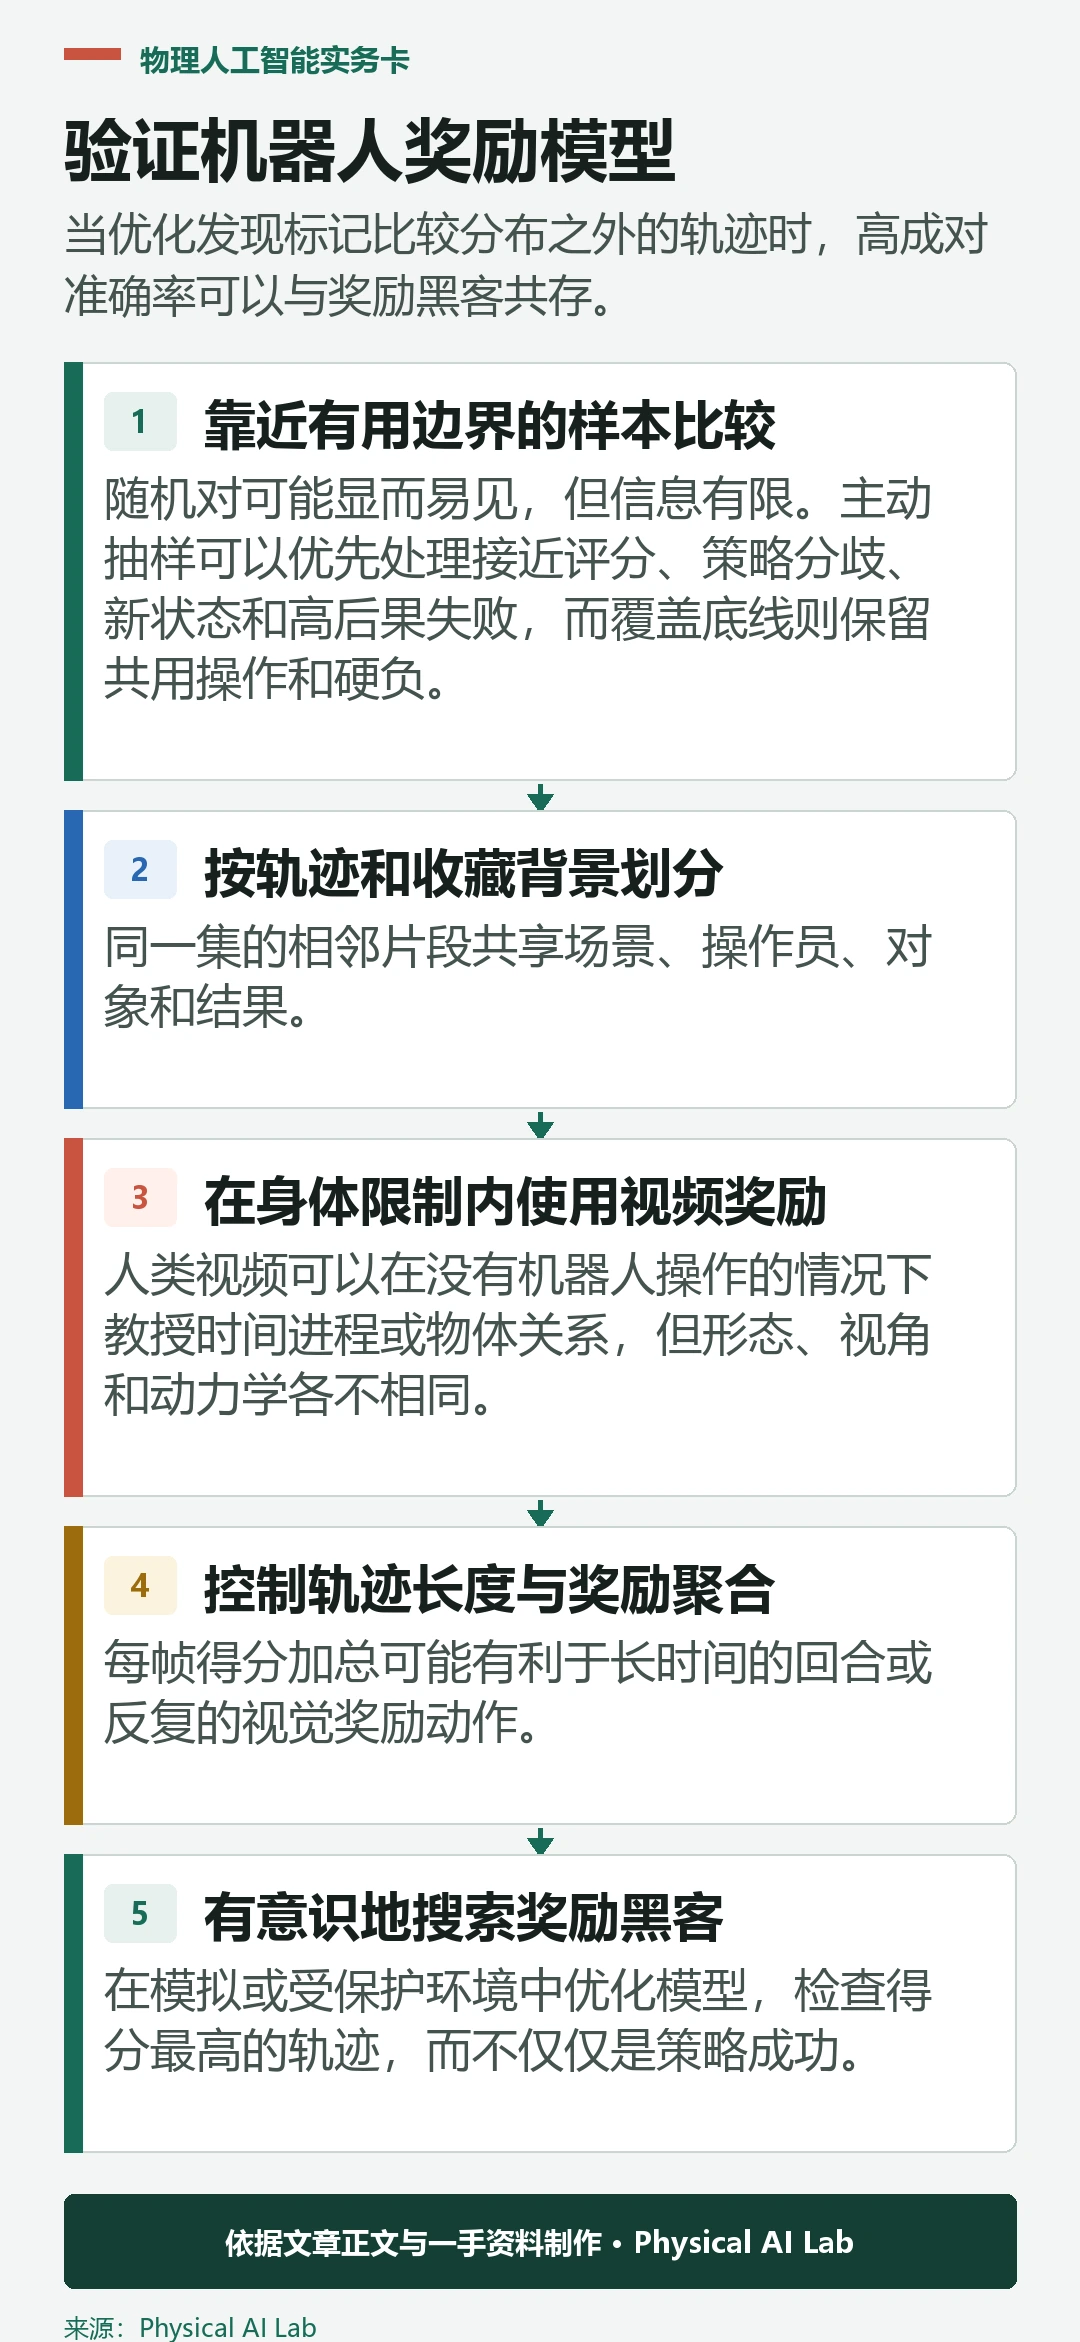
靠近有用边界的样本比较
随机对可能显而易见,但信息有限。主动抽样可以优先处理接近评分、策略分歧、新状态和高后果失败,而覆盖底线则保留共用操作和硬负。
人类偏好强化学习基于两对轨迹段偏好训练,并在其评估后的模拟运动和游戏设置中报告结果。为目标机器人重现反馈回路,而非将其标签预算作为通用值转移。
按轨迹和采集上下文划分数据
同一集的相邻片段共享场景、操作员、对象和结果。如果衍生模型交叉训练和测试,奖励模型可能识别录制会话,而非学习行为质量。
按源集分组,若声明要求,则按对象、站点、运营者或策略版本分组。保持与父路径的增强、裁剪和重叠窗口。
在身体限制内使用视频奖励
人类视频可以在没有机器人操作的情况下教授时间进程或物体关系,但形态、视角和动力学各不相同。识别人手接近物体的功能可能无法正确评分机器人抓握器。
HOLD论文研究了从人类操作视频和传递中获得的奖励性学习,并通过其模拟实验进行。将交叉身体转移视为假设,验证机器人特有的观察、失效和接触结果。
控制轨迹长度与奖励聚合
每帧得分加总可能有利于长时间的回合或反复的视觉奖励动作。平均值可以掩盖短暂的严重失误,而仅在终端评分时几乎无法提供恢复指导。
在策略优化前,定义折扣、段重叠、终端处理和失败惩罚。测试重复、停滞、逆转进展或提前结束的合成轨迹,以揭示聚合漏洞。
主动查找奖励作弊行为
在模拟或受保护环境中优化模型,检查得分最高的轨迹,而不仅仅是策略成功。生成反例,改变摄像机角度、隐藏物体、重复运动或利用集数边界,同时使真实目标未被满足。
ReQueST论文探讨了综合假设行为,以在其评估环境中寻找有信息性和不安全的案例。该方法激发了对抗性查询,但未能确立无关物理机器人的安全性。
仅校准分数以符合声明的结果
成对偏好对数并不自动表示成功概率。如果操作需要阈值,则根据可观测的未完成事件校准相关输出,并按域报告可靠性、基准率和不确定性。
调整策略后应重新校准,因为优化会改变轨迹分布。基于行为-策略数据的模型,在其帮助创建的新策略上可能不可靠。
分别评估预测、优化结果和人员判断
第一项指标为对比准确性、排名和校准。第二项指标衡量优化得分如何改变任务结果和失败模式。第三项要求独立评估者在未看到奖励分数的情况下判断结果轨迹。
包括任务成功率、安全事件、干预、时间、精力和子组偏好。学习奖励较高但独立结果较差,未能实现部署目标。
| 层 | 度量 | 警告 | 反响 |
|---|---|---|---|
| 唱片公司 | 协议与未知速率 | 评分标准歧义 | 修订指导 |
| 预测 | 被保留的排名 | 会话快捷方式 | 重组 |
| 优化 | 比分与结果 | 奖励黑客 | 增加挑战 |
| 人物 | 盲目判断 | Score不同意 | 拒绝代理 |
| 机器人 | 成功与安全 | 仅离线时的增益 | 不要部署 |
发布奖励—数据—策略包
版本评分标准、注释协议、反馈数据集、拆分、预处理、奖励检查点、聚合、校准、优化策略和挑战集。保留触发模型或人类分歧的具体示例。
关闭发布审查,需进行以下检查。
评估“来自人类与视频反馈的机器人奖励模型”时,还应保存模型版本、机器人配置、标定文件、测试日期和全部试验记录。把成功、失败、恢复与人工介入放在同一份数据中,才能区分模型能力、系统接口和现场流程造成的差异。
- 说出判断和预测的视野。
- 保留平局结果、未知项和标注者分歧。
- 按来源、轨迹和上下文划分。
- 挑战奖励漏洞优化策略。
- 比较奖励、真实成功、安全结果和人类盲评判断。
常见问题
奖励模型和成功探测器是一样的吗?
不。成功探测器预测一个明确的结果,而奖励模型可能代表偏好、进展或质量,而非轨迹。
多少个人类标签才够?
没有普遍计数;使用覆盖率、一致性、学习曲线和策略挑战结果来衡量目标分布。
VLM分数可以直接作为奖励使用吗?
只有在任务特定验证之后;通用的视觉语言评分可能会错过接触、力、时机和安全。
更好的奖励模式能否取代安全约束?
不。独立的运行时间约束和风险控制依然必要。
最快的奖励作弊检查是什么?
在沙盒中优化分数,检查得分最高的失败、重复以及摄像机或集数边界漏洞。
偏好-信号与目标-对齐边界
机器人奖励模型是记录反馈过程的学习代理。部署需要独立的任务、安全和人类判断证据,优化改变了行为分布。