开放词汇机器人目标指代定位将自由形式短语(如盒子后面的蓝色杯子)与机器人可追踪和操作的特定对象连接起来。文本条件检测使候选名称的范围超越固定的训练分类法,但操作需要几何和身份,而仅靠2D标签是无法提供的。
可部署的管道保留语言模糊性,提出多种视觉候选,通过掩码和深度细化实例,通过动作保持3D身份,并在动作前立即检查可达性、姿势、抓取和禁止区域。
将本指南与 VLA 指南 和 6D物体姿态指南一起使用。分别报告感知和操控结果。
保持用户短语及其歧义
解析中心名词、属性、关系和请求的动作,但保留原始指令和未解析的引用。规范化不应默默地用假定目标替换旁边、后方或另一个指令。
当两个对象仍然合理时,返回候选对象并提出有针对性的澄清。快速任意选择可能将感知不确定性变成不可逆的操作错误。

区分开放词汇能力与有保证的新颖物体识别
开放词汇检测器接受文本类别或引用表达式,超出封闭输出列表。它们仍继承了预训练的概念、偏见和视觉覆盖,可能在领域特定工具、透明部分或特殊视角上失败。
OWL-ViT论文报告了其基准设置中开放词汇检测结果。它并不保证对每个未见的工厂物体都能识别或具物理可操作性。
| 阶段 | 输出 | 所需证据 | 主要故障 |
|---|---|---|---|
| 语言 | 短语与关系 | 原始指令 | 含义为“丢失” |
| 检测 | 候选盒与比分 | 校准覆盖 | 目标未中 |
| 分段 | 实例掩码 | 边界与遮挡 | 合并的对象 |
| 3D定位 | 点、姿势与框架 | 深度与校准 | 错误的几何形状 |
| 行动检定 | 可达抓取目标 | 新鲜场景状态 | 不安全接触 |
在选择前先生成候选项
保留带有文本条件分数、空间证据和明确无匹配结果的顶尖候选项。阈值应根据目标摄像机和物体组合校准,因为分数分布会在不同场景和短语间变化。
Grounding DINO 是一种开放式检测器,接受类别名称或引用表达式,详见其 官方论文。将其报告的基准测试作为方法证据,而非部署阈值。
给候选对象附加一个实例掩码
边界盒可能包含相邻对象、背景层和多个深度层。遮罩为深度过滤、姿态估计和抓取生成提供了更好的表面集,但其边缘和遮蔽区域仍然不确定。
Segment Anything 论文描述了可提示的分割和零样本评估。 SAM 不会识别用户意图的命名对象;探测器、短语和场景逻辑仍然提供该链接。
将像素投影到时间对齐的3D帧中
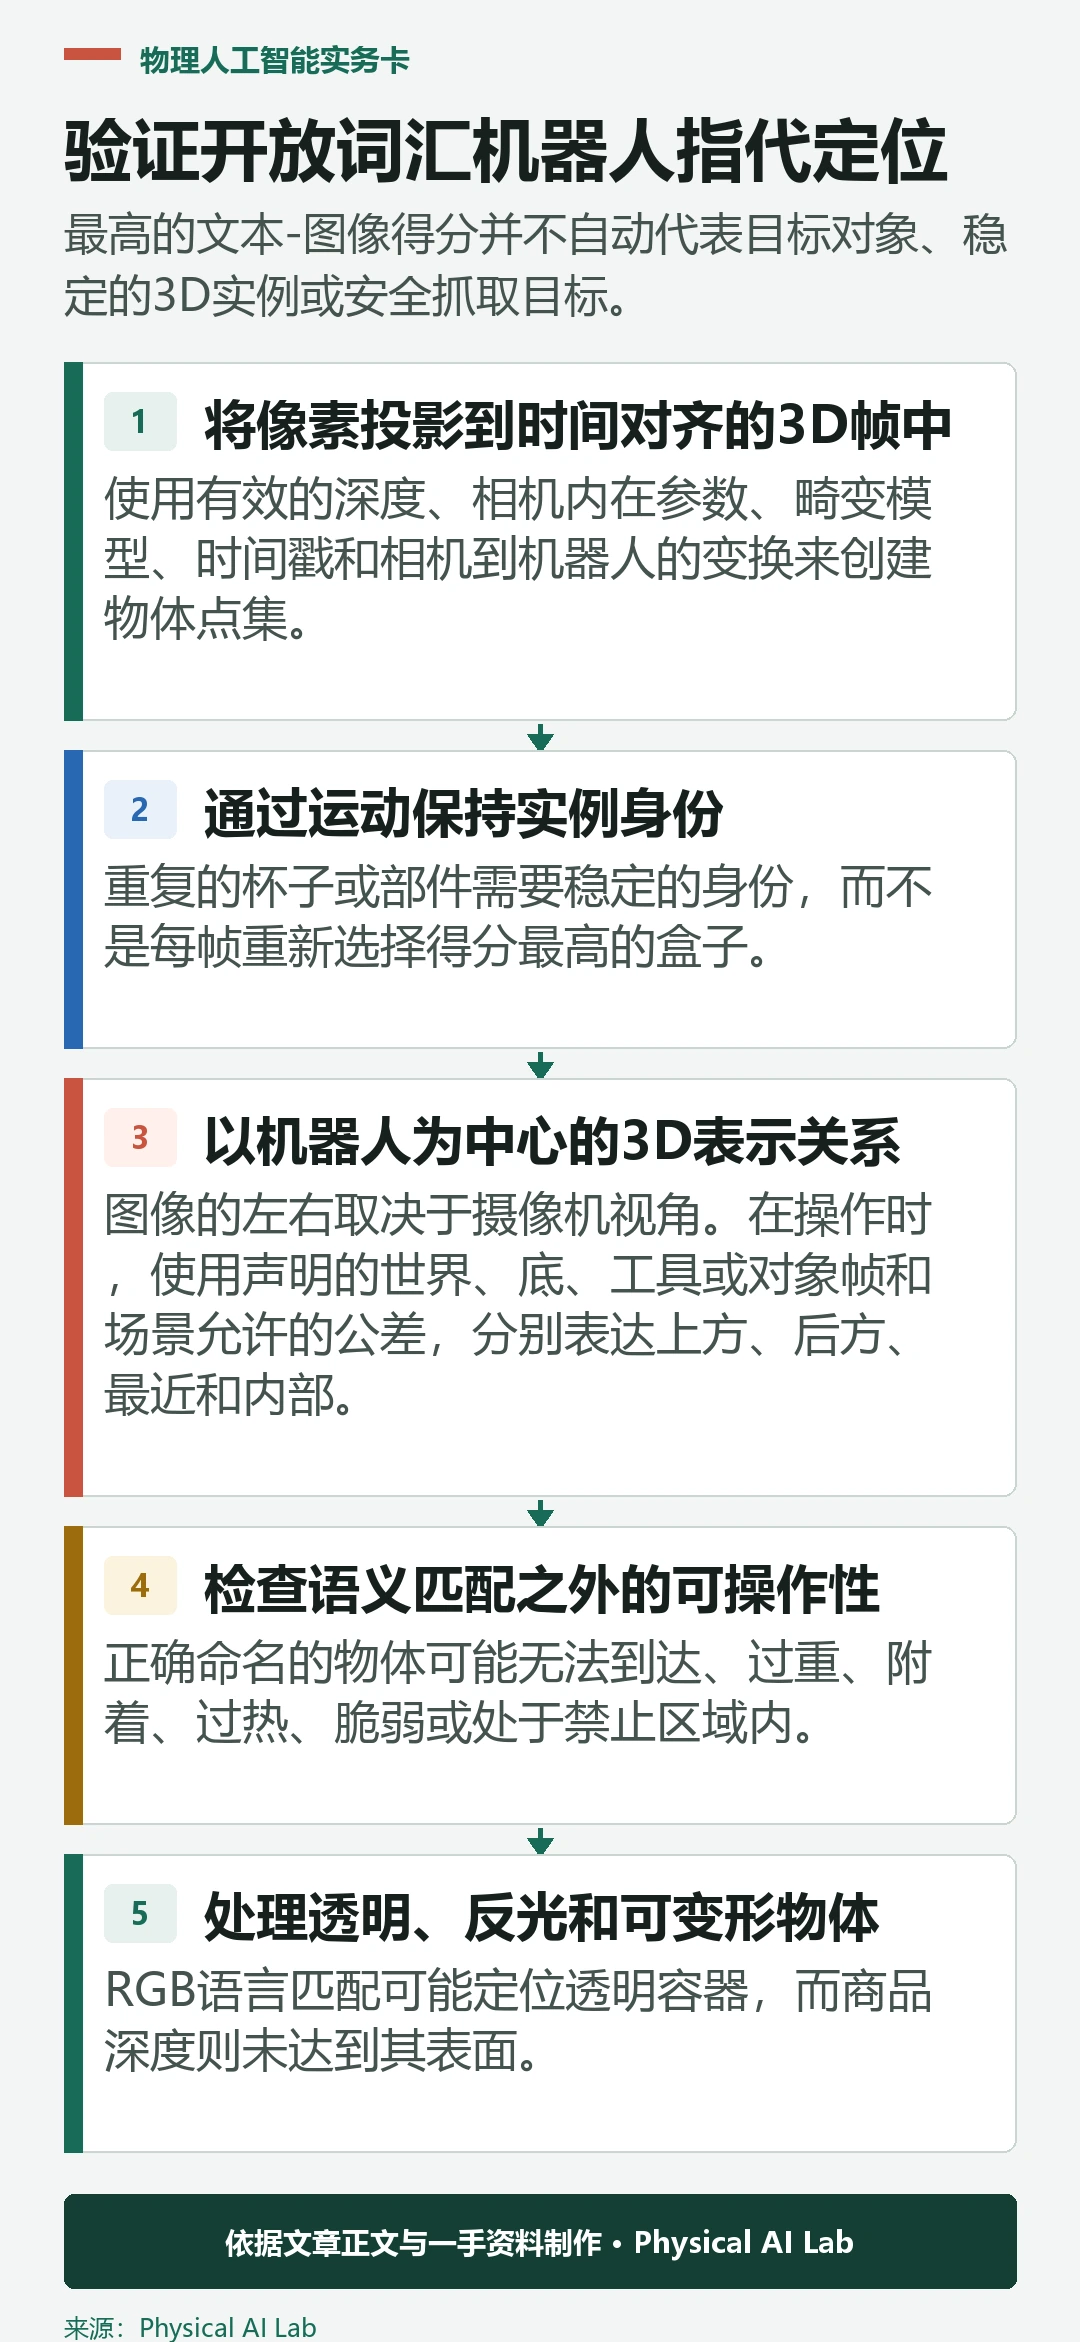
使用有效的深度、相机内在参数、畸变模型、时间戳和相机到机器人的变换来创建物体点集。拒绝或下重靠近深度不连续点和缺失或多路径测量的像素。
从时间t和后期移动摄像机帧获得深度的2D遮罩可以创建一个合理但不正确的3D目标。在发布姿势前,必须强制同步和帧有效性。
通过运动保持实例身份
重复的杯子或部件需要稳定的身份,而不是每帧重新选择得分最高的盒子。将外观、 3D位置、运动、物体状态和遮挡逻辑融合到带有明确创建、合并、分割和退场规则的轨道中。
机器人或物体运动后,更新轨道并重新定位关系语言。另一个物体的剩余对象可能不再满足原始描述。
以机器人为中心的3D表示关系
图像的左右取决于摄像机视角。在操作时,使用声明的世界、底、工具或对象帧和场景允许的公差,分别表达上方、后方、最近和内部。
在关系中保持不确定性和参考对象身份。如果引用是歧义或移动的,仅仅因为一个2D排序匹配,目标不能被视为已解析。
检查语义匹配之外的可操作性
正确命名的物体可能无法到达、过重、附着、过热、脆弱或处于禁止区域内。定位结果应返回几何形状和不确定性,同时由单独的规划器和安全层决定是否允许某项操作。
验证无碰撞方法、抓取面、工具兼容性、有效载荷、可见度及预期抓取后观测。不要让探测器分数覆盖物理约束。
处理透明、反光和可变形物体
RGB语言匹配可能定位透明容器,而商品深度则未达到其表面。反射金属可以产生混合深度,且可变形物体没有单一刚性姿态。
必要时使用任务特定感知、多视角证据或保守几何。分别报告这些对象族,而不是将它们平均为共同的不透明对象。
接触前立即重新验证
在初始指令和抓取之间,人员、机器人和物体可能会移动。在接近前和接触敏感控制开始时,刷新目标跟踪、帧变换、可达性、禁止区和抓取间隙。
如果信心下降或身份发生变化,请暂停并提出请求,而不是继续保持陈旧的姿态。将这种行为与 策略回避指南联系起来。
分层评估管道
测量短语到候选对象的召回率、引用实例准确性、掩码质量、深度效度、 3D姿态或点误差、跟踪身份切换、澄清成功率、抓取规划及最终任务结果。包含无匹配和多实例场景。
VoxPoser在其 报告的实验中展示了用于机器人操作的语言条件3D值映射。新的部署仍需独立的摄像头、物体、指令和安全评估。
| 层 | 度规 | 硬壳 | 通过问题 |
|---|---|---|---|
| 语言 | 已解决的参考文献 | 歧义短语 | 请正确提问 |
| 检测 | 候选项罢免 | 小说同义词 | 目标保留 |
| 遮罩与深度 | 有效目标点 | 遮挡或反射 | 可用几何 |
| 追踪 | 身份交换 | 重复对象 | 实例稳定 |
| 操控 | 安全任务成功 | 移动目标 | 行动已验证 |
发布视觉指称定位契约
版本文本处理器、检测器、分段器、阈值、深度滤镜、相机校准、帧变换、跟踪参数、对象限制和澄清策略。记录每个候选和决策并带有时间戳。
关闭发布审查,需进行以下检查。
评估“开放词汇机器人目标指代定位”时,还应保存模型版本、机器人配置、标定文件、测试日期和全部试验记录。把成功、失败、恢复与人工介入放在同一份数据中,才能区分模型能力、系统接口和现场流程造成的差异。
- 保留原文和未解决的歧义。
- 保留候选项和“无匹配”结果。
- 验证掩膜、深度和时间匹配的帧。
- 通过运动保持3D实例身份。
- 接触前重新检查可达性、限制条件和抓取几何。
常见问题
开放词汇检测和零样本检测是一样的吗?
它们有重叠,但开放词汇强调文本灵活标签,而零机会则描述没有目标类别训练示例的评估。
我能抓住CLIP得分最高的物体吗?
不。该分数无法确定实例身份、3D 几何、可达性或抓取安全性。
Segment Anything会单独找到一个看不见的有名字物体吗?
不。它产生可提示的掩体;语言基础必须识别代表短语的掩体。
透明物体应该如何处理?
使用适合缺失或不可靠深度的传感器或多视角方法,并保持保守的不确定性。
如果两个候选项仍然都很可信怎么办?
提出一个有针对性的澄清,明确控制权,而不是随意选择。
语言到可操作实例边界
开放词汇基础扩展了语言界面,而非操作的确定性。机器人必须将词语连接到一个新鲜、稳定的3D实例,并在接触前重新验证可操作性。