机器人 VLA 压缩减少内存、计算、带宽或能量,同时保持模型将图像和语言转化为及时机器人动作的能力。量化改变数字表示;蒸馏从教师中培养较小的学生;架构变更改变计算本身。
决定性的基准是从传感器输入到解码动作的精确部署路径,且在控制截止时间和热负载下。文件较小或离线损失较低并不保证内核更快、尾延迟降低或闭环行为稳定。
将本指南与 VLA 微调指南 及 动作词元化指南一起使用。在调整精度前,先冻结未压缩的基线。
冻结部署基线
引脚模型和处理器校验和、分词器、动作解码器、规范化、运行时、内核、编译器、设备、电源模式、控制速率和评估试验。记录冷温行为,确保压缩不会接收不同的缓存或批处理条件。
测量权重、峰值内存、输入到首次动作延迟、稳态和尾部延迟、能量、温度、节流、解码动作、任务成功率和安全事件。

分别处理权重、激活值和缓存精度
仅权重量化减少参数存储,但可能保持激活和键值缓存不变。激活量化可以节省带宽,但对异常值更敏感。缓存精度在长视觉语言上下文中非常重要。
按模块和张量类进行文档精度。标榜为四位的模型仍可包含更高精度的嵌入、范数、头或备份算符。
| 方法 | 初选变动 | 潜在增益 | 主要风险 |
|---|---|---|---|
| 仅重量PTQ | 存储权重 | 内存与带宽 | 内核回退 |
| 权重激活PTQ | 权重与激活 | 更多的计算节省 | 离群值误差 |
| QAT | 训练内容包括量子化 | 低位恢复 | 培训费用 |
| 蒸馏 | 小学生 | 端到端约简 | 教师偏见 |
| 架构变革 | 注意或标记路径 | 复杂度简化 | 配方特定回归 |
从训练后量化开始
PTQ通过校准统计转换为训练好的模型,是最快的基线。测试可按信道或组进行选择测试,并保持更高精度的模块。不要假设最小的位宽是最佳可部署点。
当前 Transformers bitsandbytes 文档 描述了支持的 8 位和 4 位路径及硬件约束。钉住文档和库版本,因为支持会变。
使用具有代表性的校准数据
校准示例应涵盖目标摄像头、光照、指令长度、物体、动作、稀有标记和失效状态。通用图像可能会错过由机器人特定视觉流和动作解码所创建的激活范围。
从训练或指定的校准分段中选择校准数据,绝不选择最终测试。报告对集合大小和抽样的领域覆盖及敏感度。
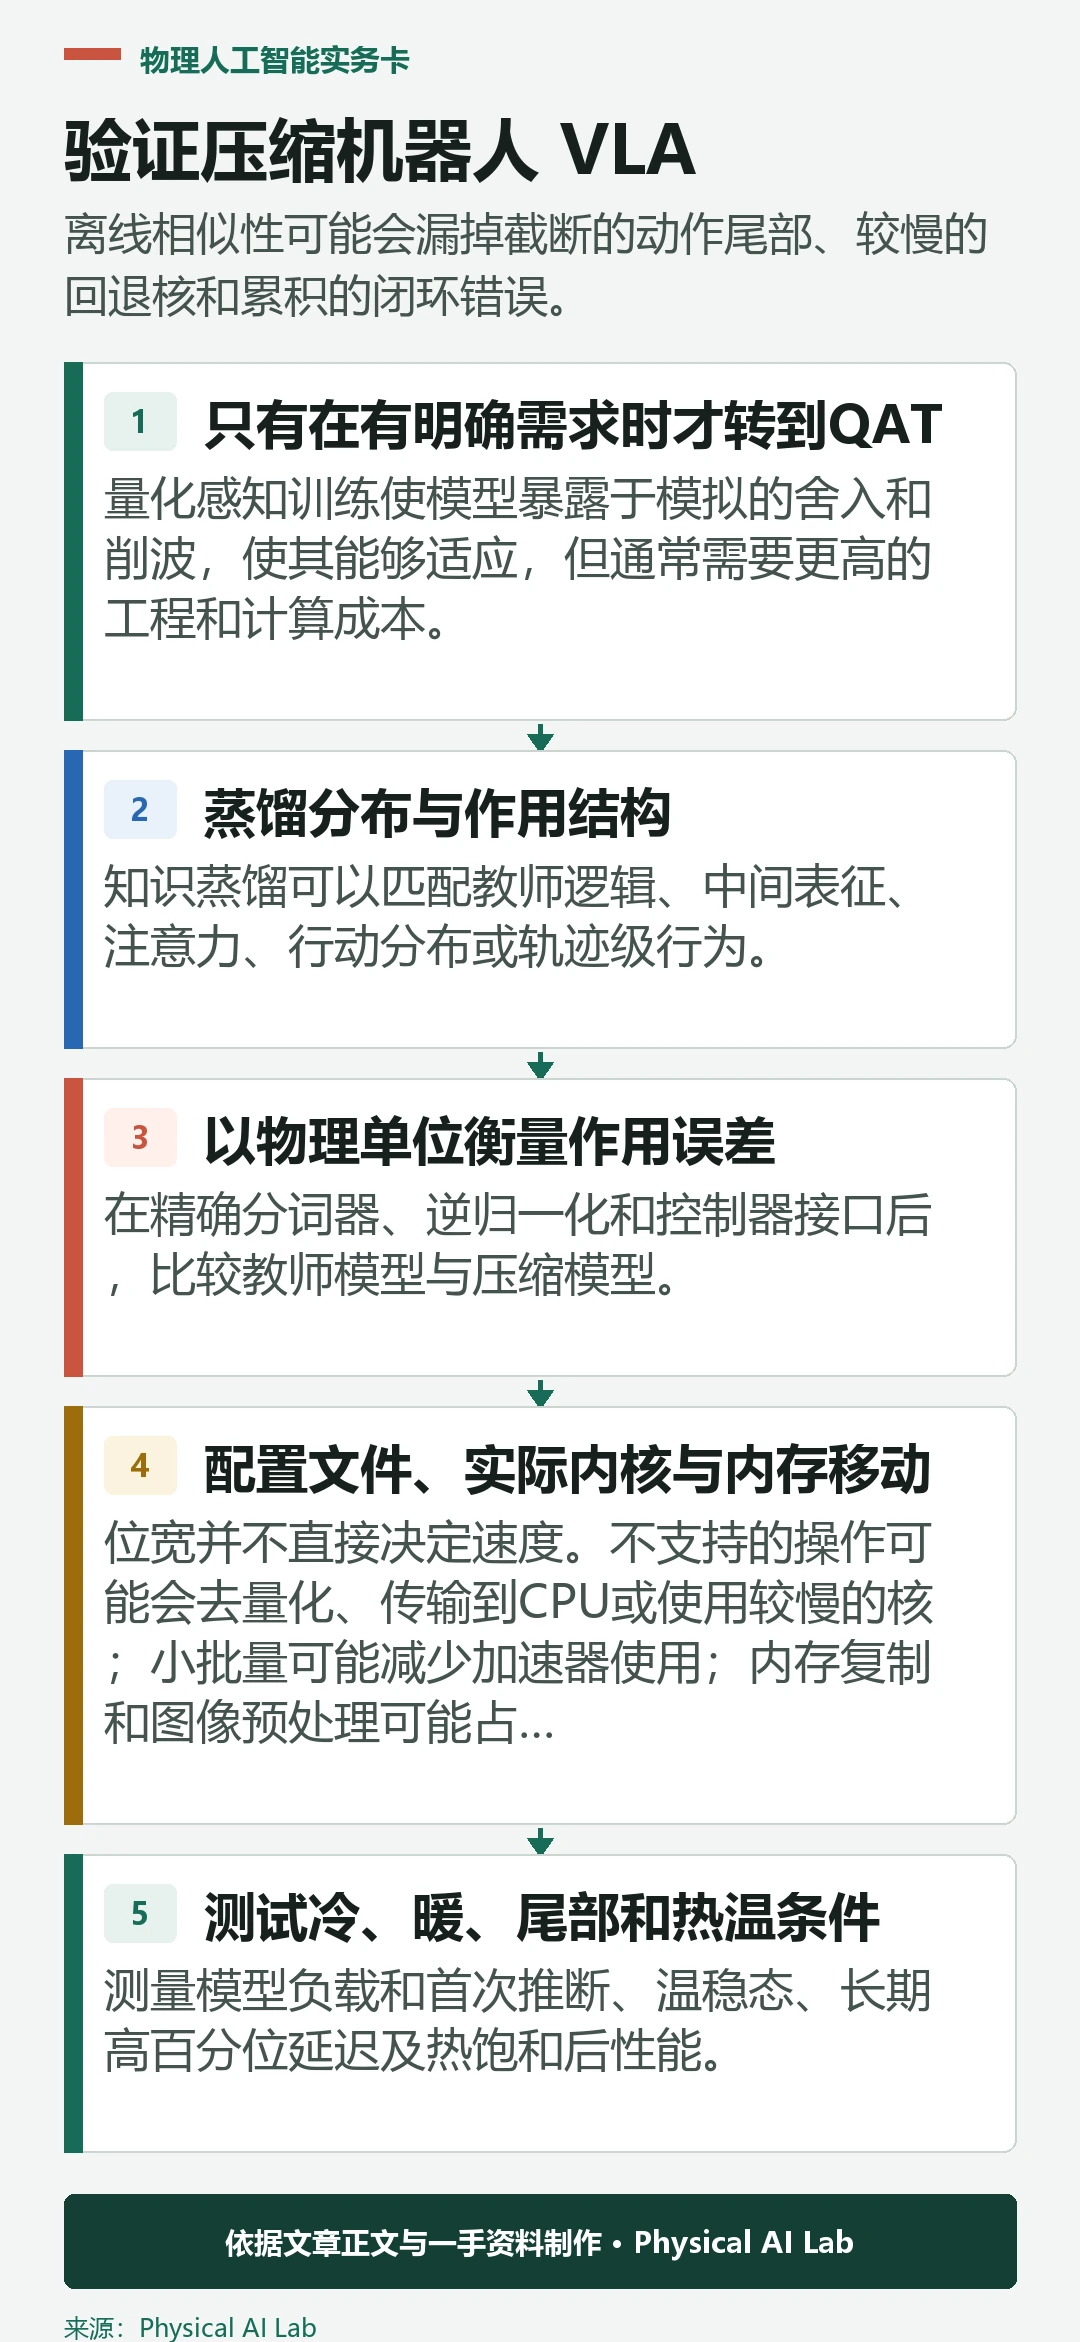
只有在有明确需求时才转到QAT
量化感知训练使模型暴露于模拟的舍入和削波,使其能够适应,但通常需要更高的工程和计算成本。在相同的比特布局和评估下与PTQ进行比较,而不是将QAT视为自动优越。
保护基地能力,并在适当情况下使用低学习率或分阶段解冻。版本对观察者、距离和输出路径进行假量化,并设置检查点。
蒸馏输出分布和动作结构
知识蒸馏可以匹配教师逻辑、中间表征、注意力、行动分布或轨迹级行为。经典 的蒸馏论文 鼓励传递软化的预测信息,但机器人策略需要行动和时间感知目标。
保持实地监督和安全惩罚,避免教师错误被无条件复制。将学生的进步与未由教师培训的同规模模型进行比较。
以物理单位衡量作用误差
在精确分词器、逆归一化和控制器接口后,比较教师模型与压缩模型。报告联合、笛卡尔、夹持器和移动基准误差、裁剪、符号变化以及作用块发散随时间的变化。
在闭环反馈下,每步的微小差异可能会加剧。应纳入接触、恢复和近边界案例,而非仅评估简单演示。
分析实际内核执行和内存传输
位宽并不直接决定速度。不支持的操作可能会去量化、传输到CPU或使用较慢的核;小批量可能减少加速器使用;内存复制和图像预处理可能占主导地位。
在目标设备上捕获操作员级跟踪。报告峰值分配和保留内存、传输、内核时间、同步和备援计数。
测试冷、暖、尾部和热温条件
测量模型加载与首次推理耗时、预热后的稳态性能、长时间运行的高百分位延迟,以及热饱和后的性能。测试应采用真实相机帧率、上下文长度,并包含并发的感知或安全进程。
一个模型达到平均延迟但错过罕见截止日期,可能会产生过时或跳过的命令。定义超时行为,并在资源争用中验证。
按模型和硬件界定结果适用范围
SARA-RT在其 论文中报告通过上级训练将研究中的机器人变换器转换为线性注意力变体。 QuantVLA项目 报告了其所述配置中的 VLA 量化工作。
这两种方法都无法为其他模型、运行时或机器人建立通用加速。在使用报告的比率前,先精确复现精度、架构、设备和任务条件。
在机器人上运行闭环回归测试
在相同且保留的试验中评估未压缩和压缩包,采用匹配重置策略、可能的种子和足够的重复次数。衡量成功率、时间、干预、碰撞余裕、恢复和失败机制。
OpenVLA仓库为支持的检查点提供实现上下文;检查特定版本的部署代码,而不是假设所有VLA架构共享相同的压缩路径。
| 基准测试 | 度量 | 警告 | 判决 |
|---|---|---|---|
| 存储 | 模型文件与内存占用 | 只有文件会收缩 | 分析运行时性能 |
| 延迟 | 中位数与尾部延迟 | 截止日期错过 | 拒绝或退回 |
| 热成像 | 持续时钟与电源 | 节流 | 变革设计 |
| 行动 | 解码物理错误 | 尾部剪裁 | 提高精度 |
| 闭环 | 成功与安全 | 仅离线的奇偶关系 | 不要发布 |
从测量的帕累托边界中选择
绘制多种精度和学生配置的内存、持续延迟、能量和任务结果。在优化成本前,去除被支配的选项,并实施硬性安全和截止日期门槛。
关闭发布审查,需进行以下检查。
评估“机器人 VLA 量化与蒸馏”时,还应保存模型版本、机器人配置、标定文件、测试日期和全部试验记录。把成功、失败、恢复与人工介入放在同一份数据中,才能区分模型能力、系统接口和现场流程造成的差异。
- 冻结准确的未压缩部署基线。
- 仅根据代表性的机器人数据进行校准。
- 分析内核执行、数据传输和达到热稳态后的尾部延迟。
- 以物理单位测量解码后的动作误差。
- 要求在发布前进行闭环任务和安全回归测试。
常见问题
4位 VLA 总是8位模型的两倍快吗?
不。内核支持、内存移动、批处理大小和未量化模块决定速度。
LoRA会让推理更小吗?
不一定。 LoRA会减少可训练参数;基础模型和运行时大小可能保持不变。
应该先试PTQ还是QAT?
先以测量的PTQ基线开始,当目标低位配置失效且训练成本合理时再使用QAT。
较低的离线动作误差能取代机器人试验吗?
不行。闭环累积、延迟和控制器交互都需要硬件评估。
蒸馏和量化能结合使用吗?
是的,但要将顺序和互动与固定教师基线和闭环门进行测试。
压缩到闭环边界
机器人 VLA 压缩是一种部署优化,而非文件大小的竞赛。从精确的设备时序、内存、功耗、解码动作和闭环证据中选择。