UBTECH GHRC 2026基线是一套官方参考管线:运行Walker S2仿真器,用键盘遥操作采集四路相机和关节数据,保存为LeRobotDataset v3,再训练并评测ACT或π0策略。稳妥顺序是先对齐Isaac Sim 5.1.0容器与GPU驱动,用官方数据完整复现一次,再加入自己的数据。若一开始就做大规模训练,很难区分环境错误与数据错误。
先明确官方基线究竟覆盖哪些环节
GHRC 2026官方技术文档提供从物理仿真、数据采集、模型训练到策略部署的一体化流程。Walker S2环境的状态空间由14个手臂关节、4个夹爪关节和2个夹爪控制命令组成,共20维;相机是头部左右与腕部左右四路RGB画面。
官方资产和训练数据另行托管在Hugging Face,代码仓库还需要下载子模块和数据集。基线让参赛者从同一起点比较结果,但不保证它是完整复刻真实Walker S2全部传感器、安全控制和动力学的数字孪生。即使仿真得分很高,实机部署仍要经过Sim-to-Real验证。
| 组件 | 官方基线中的作用 | 首次运行应检查 |
|---|---|---|
| Isaac Sim | 提供Walker S2物理环境和传感器渲染 | 容器版本、GPU识别和实时系数 |
| 键盘遥操作 | 生成任务示范和回合 | 输入设备路径、控制时延和中止键 |
| LeRobotDataset v3 | 保存图像、状态、动作和元数据 | 相机顺序、fps和回合成功标签 |
| ACT | 预测动作块的模仿学习基线 | 块长度、观测窗口和内存占用 |
| π0 | 联合处理图像、语言和动作的策略基线 | 检查点、预处理和任务语句一致性 |
安装最常卡在驱动与容器组合,而不是代码本身
官方文档的最低配置为4核CPU、32GB内存、50GB SSD、GeForce RTX 4080和16GB显存(VRAM);推荐配置为8核、64GB内存、500GB SSD和RTX 5080;理想配置为16核、64GB内存、1TB NVMe以及48GB显存的RTX PRO 6000 Blackwell。若同时训练模型,还要为存储和显存留出更多余量。
系统表列出Ubuntu 22.04/24.04与Windows 10/11,但Docker命令和键盘设备示例更接近Linux流程。基础镜像为`nvcr.io/nvidia/isaac-sim:5.1.0`,CUDA版本为12.8。文档建议使用580系列驱动,并警告安装595后,容器内Isaac Sim可能在后续阶段崩溃。更新的驱动并不总是更合适。
搭建环境前,先分别检查`nvidia-smi`、Docker访问GPU、NVIDIA Container Toolkit和可用磁盘空间;随后用官方镜像打开空场景,最后再加载GHRC资产。一次性安装所有依赖后若出现黑屏、渲染器崩溃或资产缺失,定位会很困难。还应把NVIDIA Isaac Sim官方文档中的版本已知问题与GHRC锁定版本逐项对照。
首轮运行要确认四路相机与20维状态指向同一时刻
界面出现Walker S2且按键有效,并不代表数据管线正常。应核对头部左右和腕部左右图像是否按正确名称与顺序保存,关节状态与命令是否使用同一时间轴,以及丢帧是否写入元数据。左右相机对调后,训练可能照常运行,却会学到错误的手物关系。
遥操作输入通过Linux的`/dev/input/event*`寻找键盘设备。若没有把对应设备挂载进Docker,宿主机能看到按键,仿真器却收不到。自动扫描识别到多个设备时,最好使用`/dev/input/by-id/`中的稳定链接,也能减少重启容器后event编号变化的问题。

LeRobotDataset v3的核心是回合定义,不只是文件夹格式
LeRobotDataset v3用统一方式保存并读取不同机器人的图像、状态和动作数据。Hugging Face LeRobot官方文档把数据集工具、机器人接口和训练策略放进同一生态。GHRC基线采用该结构,因此公开数据和自采回合可以用相同工具处理。
文件能打开并不等于数据合格。必须固定回合初始状态、任务语句、成败标准、操作者介入、相机fps和关节频率。`Part_Sorting`、`Conveyor_Sorting`、`Foam_Inlaying`和`Packing_Box`等任务名称对应不同物体和结束条件,应分别管理。悄悄删除失败尝试,会让策略学不到恢复,也会扭曲评测分母。
| 数据QA项目 | 可接受标准示例 | 出错时的表现 |
|---|---|---|
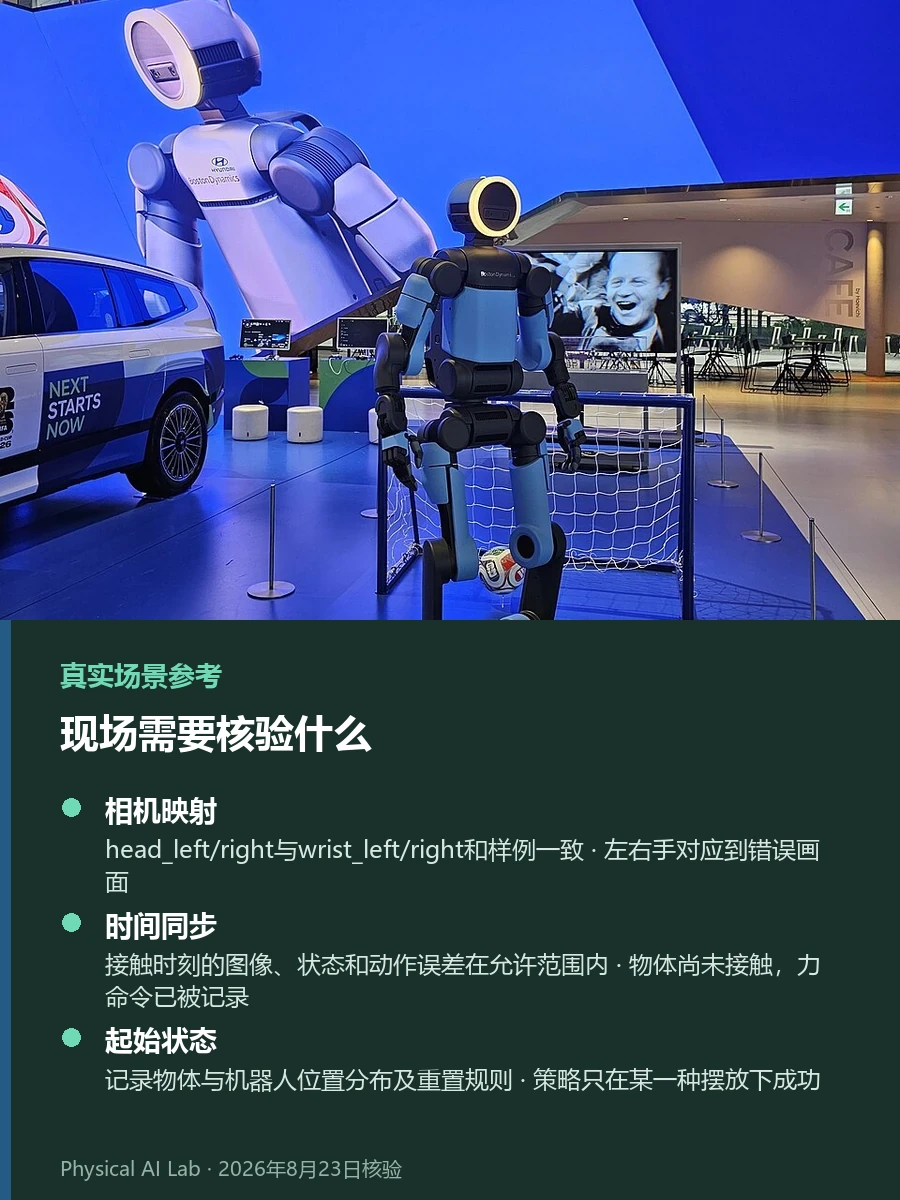
| 相机映射 | head_left/right与wrist_left/right和样例一致 | 左右手对应到错误画面 |
| 时间同步 | 接触时刻的图像、状态和动作误差在允许范围内 | 物体尚未接触,力命令已被记录 |
| 起始状态 | 记录物体与机器人位置分布及重置规则 | 策略只在某一种摆放下成功 |
| 任务语句 | 同一任务使用相同语义和名称 | π0把措辞差异理解成不同任务 |
| 数据拆分 | 按场景和物体分开训练与评测 | 验证分高,但新摆放立即失败 |
| 失败保留 | 保存中止原因和最后有效帧 | 无法计算失败率与恢复能力 |
ACT适合先验证复现,π0需要更宽的输入条件
ACT属于预测短动作块(action chunk)、再把长操作连续起来的模仿学习方法。输入输出结构相对清晰,适合检查数据管线是否正常。起步阶段应先用官方检查点和数据复现训练与推理,再有意删除少量数据或遮挡相机,观察敏感度。
π0路线把图像、自然语言任务指令和机器人状态放进通用策略,更容易扩展到多类任务,但前提是语句预处理、检查点兼容、内存要求和机器人动作表示全部匹配。不能因为它名称更新就直接判定优于ACT;两者应使用同一评测回合和同一成功标准。相关背景可继续阅读机器人基础模型。
比较时不能只看训练损失和平均成功率,还要分开统计各物体失败、长任务累计误差、相机遮挡、起始位置变化,以及错误任务语句触发的动作。至少更换三组随机种子和数据拆分并记录波动,可以降低偶然挑中一个表现良好检查点的风险。
训练之前,先保证推理结果能重新写回数据集
官方策略推理示例为`lerobot_record.py`指定`walker_s2_sim`与检查点路径,再把运行结果保存成评测数据集。默认开启视频记录,官方参数表给出的默认值为30fps、单回合60秒和50个评测回合;文档还建议用`eval_`前缀区分评测仓库。
保留这一结构很重要。策略失败时,必须能同时重开图像、状态和动作,才能判断原因在感知还是控制。仅观看评测视频并手工计数,容易让检查点与环境版本分离。若在结果数据集中追加Git提交、资产版本、策略哈希、随机种子和驱动信息,其他团队更容易复现同一失败。
仿真成功后,现实里的时延、摩擦与安全控制仍然存在
Isaac Sim中的摩擦系数、关节响应和相机噪声不会与真实Walker S2完全一致。仿真里机器人手准确触碰纸箱,现实中仍可能因标定误差、通信时延、电机回程间隙和照明反射改变接触点。这正是Sim-to-Real核心概念中的域随机化与少量实机校准要解决的问题。
实机部署前,应把速度、力和作业区限制放在学习策略之外的安全层,从空旷区域和轻物体开始,并验证有人靠近时是否立即停车。仿真成绩用于筛选策略候选,不是在人旁运行的安全认证。完整具身智能(Physical AI)背景可参考具身智能的含义与边界。
第一天的目标应是完整复现记录,而不是高分
第一天完成官方环境构建,用提供的检查点跑两个回合,并确认图像、状态和动作都被保存,就已经足够。第二天可用官方数据的小样本训练ACT,复现损失与推理;然后在相同评测集上运行π0,最后再加入少量自己的遥操作数据。
不跳过中间结果,就能逐步判断问题来自容器、资产、数据还是模型配置。GHRC基线的价值不在于只运行一次最新模型,而在于让参赛者共享可比较的环境、数据与评测流程。
官方积分榜没有的诊断也应保留。成功率相同,一个策略可能很早安全中止,另一个却在最后掉落物体。把任务完成时间的中位数和最差值、失败前动作与安全限制触发次数放在一起,才能看到单一分数隐藏的差异。再按新物体、新照明和新起始姿态拆分评测场景并公布分组结果,才能区分对官方数据过拟合的检查点与真正泛化的策略。
常见问题
ACT和π0只能二选一吗?
不是。官方基线把它们作为可比较起点;实务上可先用ACT验证数据流,再在相同评测条件下核对π0的增益和额外成本。
使用LeRobotDataset v3后,数据质量会自动统一吗?
不会。格式统一不代表相机映射、时间同步、起始状态、成功标签以及训练与评测拆分已经正确,仍需人工验证。
仿真成功的策略能直接运行在真实Walker S2上吗?
不能。物理、传感器和时延差异仍在,实机还需要标定和安全限制;仿真结果只能帮助缩小实机候选范围。
已核验的官方资料
最后核对:2026年8月23日