ロボットデータファクトリーは、映像を大量保存する施設ではない。実機と人の実演からデータを集め、利用権を確認し、学習と評価を分離し、検証済みモデルだけを現場へ配備して失敗を回収する運用体系だ。保存容量よりも、「どんな失敗がなぜ起き、どのモデルを直したか」を追跡できることが重要になる。
データを現場の実行能力へ戻して初めてファクトリーになる
LG Electronicsは2026年8月、ソウル・良才R&DキャンパスでData Factoryを建設中で、年末の全面稼働を目指すと発表した。住宅・製造現場を再現する学習空間、物流自動化、ロボットハンドのデータ収集空間を含む。LG Electronics・NVIDIAロボット協業の公式発表によると、収集データをNVIDIAロボティクススタックで拡張・合成し、LGのRobot Foundation Model改善へ使う計画だ。
規模も現在値と目標へ分けて読む。施設は地下1階、地上3階、延べ1万㎡で、LGは年末までに数百台のロボットを置くとしている。直接収集と合成・拡張を合わせ、年末に10万時間、約12年分へ達するとの数字も、達成結果ではなく同社予測だ。
SEER Roboticsも2026年の戦略発表で、実機収集、複数源の収集、ガバナンス、学習、シミュレーション評価、能力フィードバックを結ぶデータ体系を示した。両例の共通点は、一度保存して終えるのではなく、データを現場の実行能力へ戻すことにある。
| 工程 | 残すもの | 欠落時の問題 |
|---|---|---|
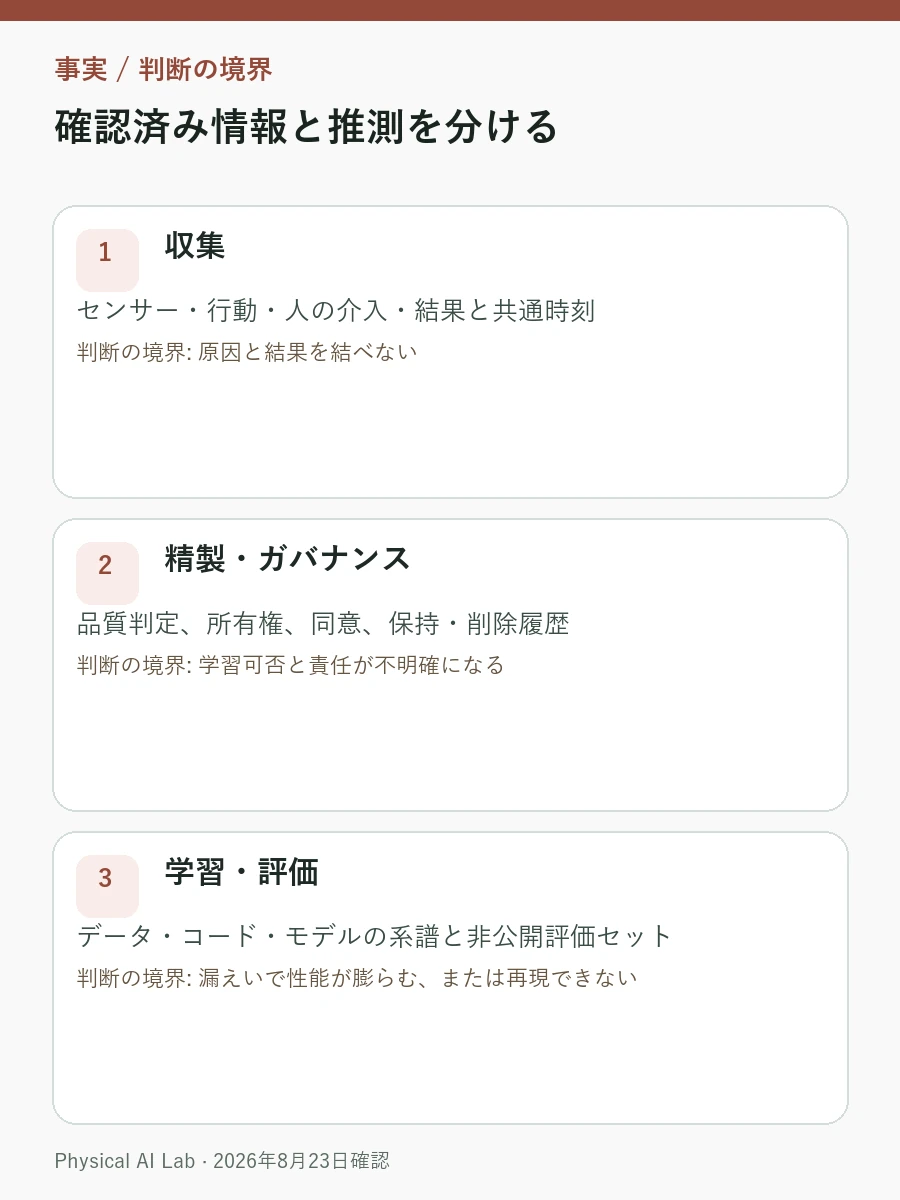
| 収集 | センサー・行動・人の介入・結果と共通時刻 | 原因と結果を結べない |
| 精製・ガバナンス | 品質判定、所有権、同意、保持・削除履歴 | 学習可否と責任が不明確になる |
| 学習・評価 | データ・コード・モデルの系譜と非公開評価セット | 漏えいで性能が膨らむ、または再現できない |
| 配備・回収 | 承認、カナリア、現場指標、ロールバック、失敗再収集 | 不良更新がフリート全体へ広がる |
収集単位は映像ファイルではなく作業エピソード
カップを棚へ入れる場面を映像だけで撮っても、ロボットが何を見てどんな力を出したかは分からない。一作業エピソードにはRGB、深度、触覚、関節位置・速度、力・トルク、命令、電池状態、遠隔操作、安全停止、最終結果を同じ時間軸で入れる。開始状態と成功、部分成功、失敗、中止の基準も作業ごとに固定する。
成功例だけでは、失敗直前の信号を学べない。濡れた取っ手の滑り、部分遮蔽、通信遅延、人が作業区域へ入った瞬間、遠隔担当者の介入理由を別ラベルで残す。正常場面を1万回反復したデータより、異なる失敗100件の方が改善方向を明瞭にする場合がある。
収集量を時間で報告する際は、実動作時間、待機・再設定時間、重複フレーム率を分ける。「10万時間」は保存量であって、作業多様性や有効データ率を自動的に証明しない。
収集設計には保存しないものも含める。全カメラ原本を無期限で持てば、費用と個人情報の露出面だけが増え得る。事故分析用原本、学習用精製データ、運用統計用要約を保持期間で分け、不合格エピソードは隔離する。隔離データが次の学習セットへ紛れないよう、状態遷移と承認者をシステムで強制したい。
時刻同期が崩れると接触の因果が逆転する
ロボットセンサーは周期が異なる。カメラは30Hz、関節状態は数百Hz、触覚イベントはさらに速い場合があり、遠隔操作命令には通信遅延が加わる。共通時計と遅延メタデータがなければ、滑った後に力を弱めたのか、弱めたため滑ったのかが逆転する。
原タイムスタンプを保持し、再サンプリングと補間は別の派生版へする。センサー校正値、ファームウェア、ロボット識別子もエピソードへ結び、後から同じファイルを再生できるようにする。フレーム欠落や時刻ジャンプを黙って埋めず、品質フラグとして残す。
ラベル定義も技術課題だ。「成功」を物体が目標区域へ入った瞬間とするか、ハンドを安全に抜くまでとするかで同じ作業の数値が変わる。運用・学習チームが完了条件へ共同署名すれば、現場KPIとモデル評価の乖離を防げる。

ガバナンスは顧客データを使える範囲を定める
ロボットは工場設備、作業者の顔、住宅内部、製品不良など機微情報を同時に記録し得る。機器を買えば顧客が原本・派生データと学習モデルの全権利を自動取得するわけでも、ベンダーが全ログを他の顧客向けモデルへ自由に使えるわけでもない。収集前に契約と技術統制をそろえる必要がある。
権利表には原本の所有者、学習・評価の利用目的、第三者共有・国外移転の可否、保持期間と削除方法、派生モデルの権利主体を書く。人の映像は最小収集、仮名化、アクセス制御を初期値とし、削除依頼時にはそのデータから作った派生セットまで追えるようにする。
権限はフォルダー単位より役割・作業単位へ絞る。原映像閲覧、ラベル修正、学習承認、配備承認を一アカウントへ集中させると、事故や内部脅威を追いにくい。変更は利用者、時刻、理由、旧値とともに監査ログへ残す。
削除方針は文書だけでなく、定期的に復旧不能性を試す。特定作業者・顧客現場のエピソードIDから原本、複製、ラベル、学習候補をすべて検索し、所定手順で除去できる必要がある。既存モデルへの対応は契約とリスクで異なるため、「データ削除」と「モデル廃棄」を同じボタンで約束してはならない。バックアップの期限と復元時の再削除も見落としやすい。
合成データは希少な危険条件を補う
NVIDIA Cosmos公式ページは、センサーデータの整理、注釈、重複排除と、世界基盤モデルによる合成データ、学習・評価フレームワークを紹介する。合成は夜間、悪天候、部分遮蔽、衝突直前など、実環境で反復するには危険・希少な条件を広げるのに役立つ。
ただし、合成映像の物理的なもっともらしさは、実センサーと接触の再現を保証しない。反射材、透明物、モーターバックラッシュ、カメラノイズ、予測困難な人の行動はシミュレーションと違い得る。合成で学習後、未使用の実機データで別評価し、合成比率を変えた際に減った失敗と増えた失敗を確認する。
出所タグも維持する。実機、遠隔操作、シミュレーション、生成データを混ぜた後に出所を消せば、性能向上への寄与や特定失敗を生んだ偏りを追えない。
学習と評価の隠れた重複を防ぐ
連続撮影が多いロボットデータをフレーム単位で無作為分割すると、ほぼ同じ場面が学習と評価の双方へ入る。同じ家、物体、操作者の連続エピソードを分ければ、一般化したように見えても場面を記憶しただけかもしれない。作業、場所、ロボット、日付、物体群の単位で分ける。
非公開評価セットはモデル開発者が繰り返し閲覧できないよう管理する。配備前に実験室評価、現場シャドーモード、限定カナリアフリートの順で通す。平均成功率に加え、作業別最低性能、介入率、衝突直前停止、復旧時間、旧モデルからの退行を見る。
評価セットが古ければ現場変化を逃すが、新失敗を即座に加えて開発者が反復調整すれば再び漏えいする。運用中の事例を原因分析用と次版候補へ分け、評価版の変更日・理由を固定する。旧モデルも新版評価で再実行して改善幅を公平に比べる。単一スコアではなく作業・環境別の性能表を保てば、特定顧客での低下が平均へ隠れにくい。
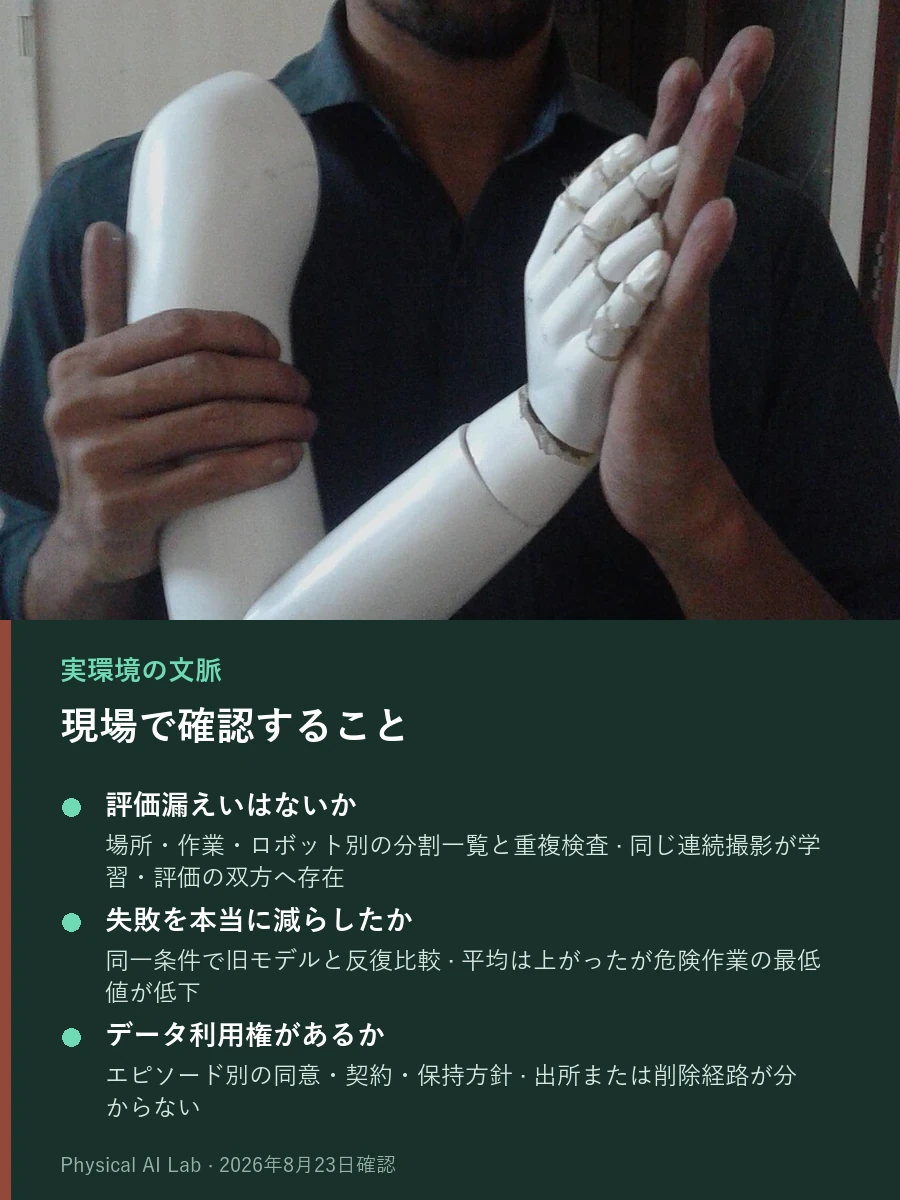
| 検証質問 | 合格証拠 | 中止・再作業の信号 |
|---|---|---|
| 評価漏えいはないか | 場所・作業・ロボット別の分割一覧と重複検査 | 同じ連続撮影が学習・評価の双方へ存在 |
| 失敗を本当に減らしたか | 同一条件で旧モデルと反復比較 | 平均は上がったが危険作業の最低値が低下 |
| データ利用権があるか | エピソード別の同意・契約・保持方針 | 出所または削除経路が分からない |
| 現場で戻せるか | モデル系譜、カナリア結果、自動ロールバック訓練 | どのデータで作ったモデルか不明 |
配備は自動更新より安全ゲートを先に置く
現場ログの到着直後に学習し、全ロボットを更新する構造は速いが危険だ。誤ラベルの失敗、壊れたセンサー、攻撃者の混入データがフリート全体の行動へ広がり得る。収集と学習を自動化しても、配備承認は別の安全ゲートを通す。
モデルレジストリーにはデータ版、コード・環境、評価結果、承認者、適用ロボットを結ぶ。最初は交通量が少なく回収しやすい機体だけへ配備し、介入率、作業時間、安全停止、ハードウェア温度を旧版と比べる。しきい値超過時に新版を止め、検証済み版へ戻す手順を実際に訓練する。
現場フィードバックのすべてを学習対象にはしない。センサー故障、運用ミス、工程変更など、モデルで解けない原因を先に分離する。目的はログの大量消費ではなく、次の改善に必要なログを正確に選ぶことだ。
初回構築は100エピソードで系譜を試す
大規模保存先を先に買わず、一作業・ロボット一台を選ぶ。サンプル100エピソードを集め、映像、関節、力、介入信号が同時再生できるか確認し、データ一件が収集から削除まで通る経路を追う。次に失敗条件を意図的に加えて非公開評価を作り、小モデルをカナリア機一台だけへ配備する。
ロボット触覚センサー、テレオペレーションデータ、模倣学習と強化学習の比較は、収集信号、実演データ、学習方式の違いを理解する助けになる。
構築指標を総時間だけにしない。有効エピソード率、作業・物体・環境の多様性、失敗・人介入の分布、権利確認率、評価漏えい件数、モデル別ロールバック時間を月次で見る。これらがつながって初めて、ファイル群がロボット能力を蓄積する資産へ変わる。
費用表には保存とGPUだけでなく、ラベル確認、現場リセット、センサー校正、個人情報処理、データ持出し審査、失敗再現の時間を入れる。安価な正常場面を集め続けるより、希少な失敗を安全に再現し原因を確かめる方が高くつく場合がある。どのデータ群がどの現場KPIを改善したか結べなければ、規模が増すほど止めるべき収集を見つけにくい。
よくある質問
大量のロボット映像を保存すればデータファクトリーになるのか
ならない。映像、状態、行動、人の介入を同期し、権利、品質、学習、非公開評価、配備、失敗回収までつなぐ必要がある。映像だけでは行動原因を再現しにくい。
合成データだけで実機方策を学習・配備できるのか
一部能力と希少場面の学習には使えるが、実センサーノイズ、接触、機体差は残る。合成へ使っていない実機データと限定的な現場配備で検証する必要がある。
顧客現場で収集したデータは自動的にロボットベンダーの所有物になるのか
契約次第である。原本、派生データ、モデル、ログの収集、学習、共有、国外移転、削除に関する権利を個別に記し、個人情報と営業秘密も別途統制する。
確認した公式資料
最終確認:2026年8月23日