SEER Roboticsが掲げる「100万台」は、現在の導入実績ではない。Ladder Programのパートナーと2030年までにエンボディドAIロボット100万台の配備を目指す長期構想だ。巨大モデルだけに集約せず、判断を担うモデル、運動を担う小脳、センサーとアクチュエーターを結ぶ神経系、現場データを学習へ戻すネットワークを一体で築く。
100万台は2030年の目標で、現在の配備数ではない
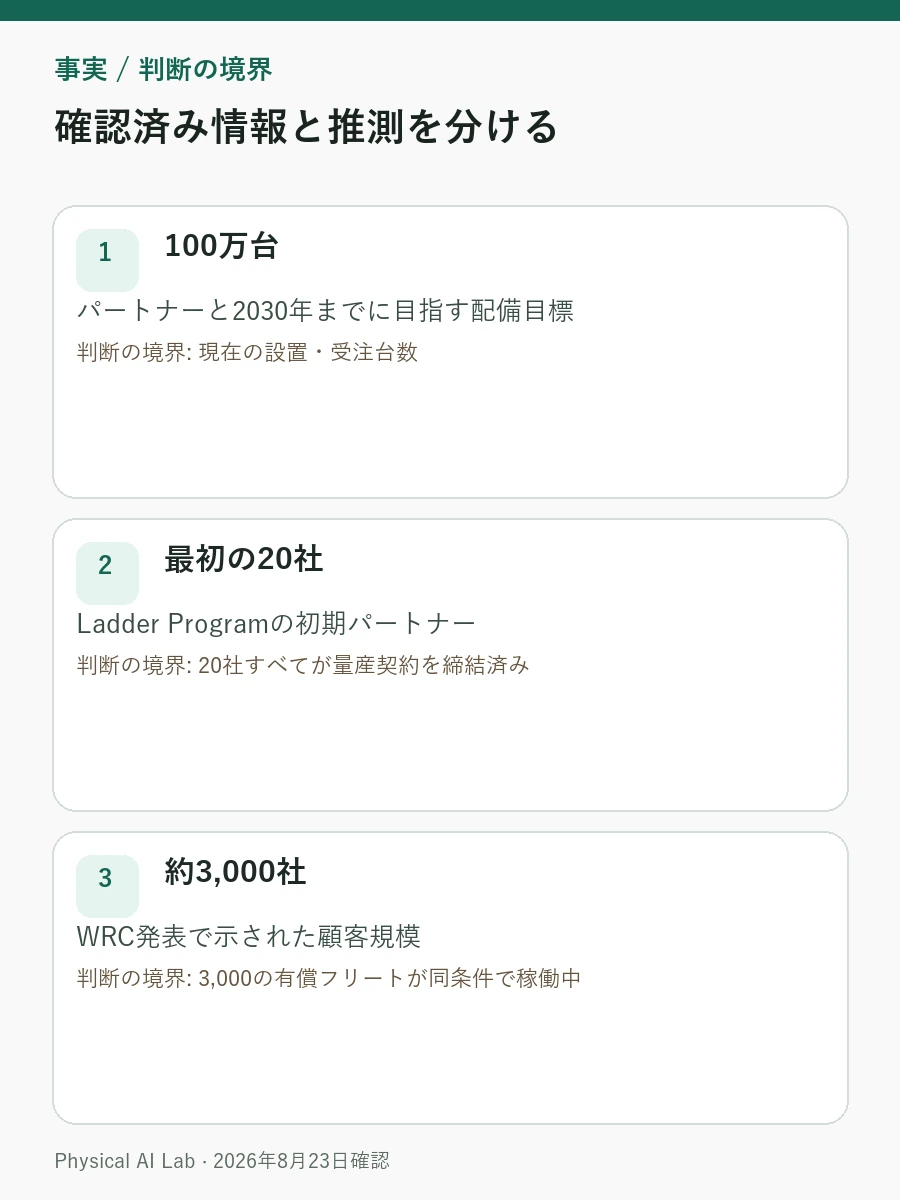
SEER RoboticsのWRC 2026発表は、Ladder Programを通じ、パートナーと2030年までにエンボディドAIロボット100万台を配備する方針を示した。最初の20パートナーも公表済みだ。ただし、目標と参加枠組みが決まったことは、100万台の受注や現場稼働を意味しない。
同じ発表で同社は、約3,000社の顧客、20超の産業分野、400超の主要部品への適応体制も挙げた。これは同社が示すエコシステムの規模である。一社が複数台を使う場合も単発案件の場合もあり、顧客数を台数や反復売上へ置き換えることはできない。SEER公式サイトと各時点の発表で顧客数が異なる可能性もあるため、数字には公表日と定義を添えたい。
| 数字 | 公式資料が示す範囲 | 避けるべき読み替え |
|---|---|---|
| 100万台 | パートナーと2030年までに目指す配備目標 | 現在の設置・受注台数 |
| 最初の20社 | Ladder Programの初期パートナー | 20社すべてが量産契約を締結済み |
| 約3,000社 | WRC発表で示された顧客規模 | 3,000の有償フリートが同条件で稼働中 |
| 20超 | 同社が示す適用産業の幅 | 全産業で同じモデルを検証済み |
| 400超 | 主要部品への適応体制 | 全バージョン・全組合せの互換性と安全認証を完了 |
汎用ブレインはモデル・小脳・神経系の三層で動く
SEERはロボットブレインをモデル、小脳、神経系に分ける。モデル層は環境を理解し、作業を計画して意思決定する。小脳層は計画を運動軌道へ変換し、リアルタイム実行を安定させる。神経系層はセンサー、関節、アクチュエーターと通信するインターフェースやプロトコルを担う。
この分離が要るのは、実機では処理の時間尺度が違うからだ。「パレットを持ち上げ、目的地へ運ぶ」という計画は比較的ゆっくり作れる。一方、走行中の人回避や車輪速度の補正は、はるかに短い周期で処理しなければならない。上位モデルの推論が遅れたり誤ったりしても、下位制御と安全層が不安定な命令をそのまま通さない境界が必要になる。
したがって、汎用ブレインを「大きなAIモデル一つ」と捉えると製品評価を誤る。作業理解だけでなく、リアルタイム制御周期、対応ハードウェア、通信遅延、安全停止、バージョン互換性がそろって初めて、現場の仕事を完了できる。
400種類超の部品対応は互換性マトリクスで確かめる
フォークリフト、AMR、四足歩行ロボット、ヒューマノイドでは、センサーも駆動系も異なる。同じ命令でも、車輪型の速度制御とヒューマノイドの姿勢制御では再利用できる範囲が違う。400超の主要部品をつなぐ構想には、多様な身体へ対応する土台を広げる意味がある。
ただし、部品名が一覧に載るだけでは現場互換性を証明できない。ファームウェア、ドライバー、通信周期、安全状態、校正値、長期供給まで整合する必要がある。センサー交換後に遅延が増えたり、アクチュエーターのトルク上限を誤認したりすれば、上位モデルの計画が正しくても実行は破綻する。
導入側は対応可否を二択で聞かず、ロボット機種×部品×ファームウェア×ブレイン版のマトリクスを求めたい。新版の再検証責任、サポート終了部品の代替手段も総保有コストへ入れる。

実機データ子会社は失敗を学習資産へ変える
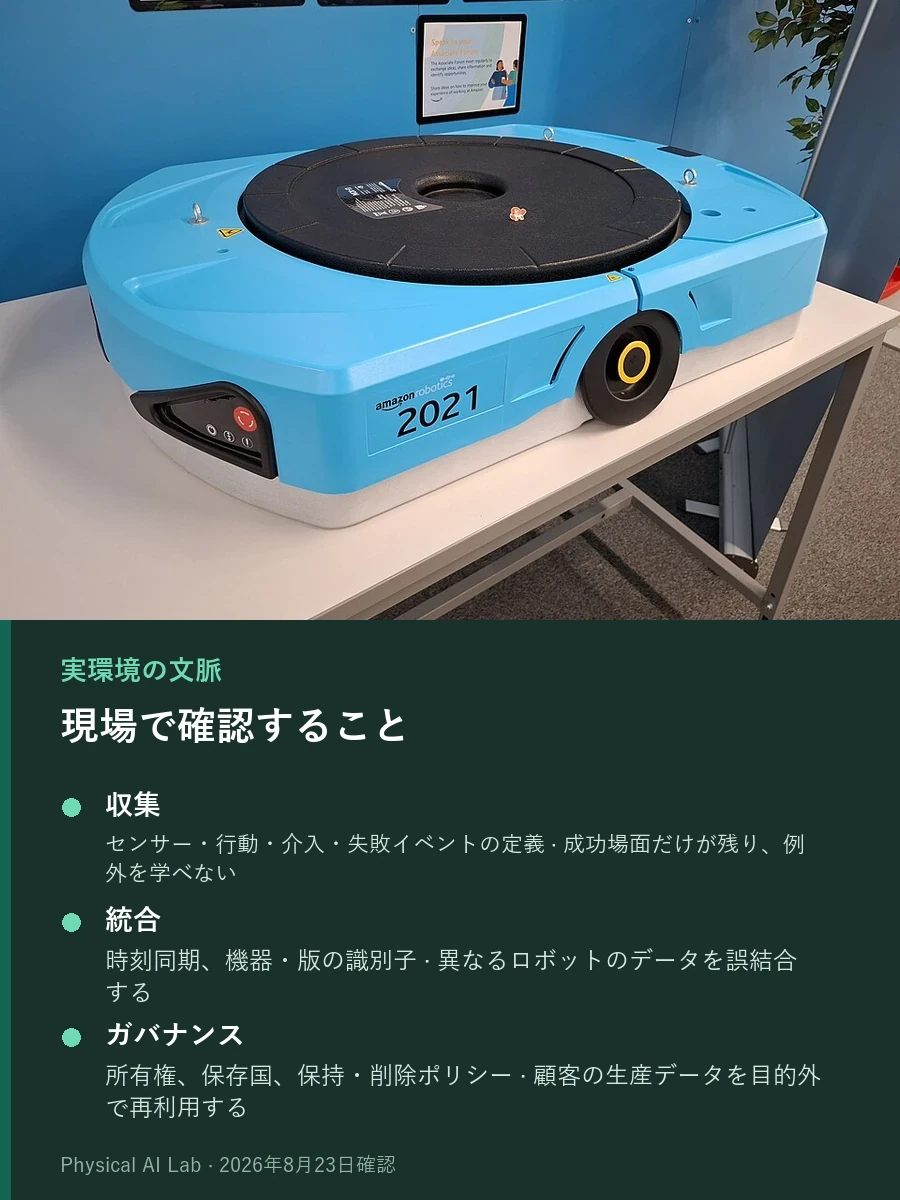
SEERが描くデータ工程は、収集、複数ソースの統合、ガバナンス、学習、評価、現場フィードバックへ続く。作業停止や遠隔介入の場面を集め、次のモデル改善へ戻す閉ループだ。
黒いパレットと青いパレットを見分けるフォークリフトを例にすると、色を当てるデモだけでは足りない。パレットが傾いた場合、人が通路へ入った場合に俯瞰視点のBEV認識がどう変わるか、介入前後をどのラベルで保存するか、新ポリシーが既存の得意作業を壊していないかまで評価する。
不適切なポリシーが生んだ偏ったデータをそのまま再学習すれば、誤りは増幅しかねない。現場データの到着を自動学習・自動配布へ直結させず、品質審査、安全評価、承認、限定配布、ロールバックのゲートを置くべきだ。
| データ工程 | 運用側が確認する文書 | 想定される失敗 |
|---|---|---|
| 収集 | センサー・行動・介入・失敗イベントの定義 | 成功場面だけが残り、例外を学べない |
| 統合 | 時刻同期、機器・版の識別子 | 異なるロボットのデータを誤結合する |
| ガバナンス | 所有権、保存国、保持・削除ポリシー | 顧客の生産データを目的外で再利用する |
| 学習・評価 | 基準モデル、テストセット、回帰評価 | 新機能が既存作業の性能を落とす |
| 配布・フィードバック | 承認範囲、段階配布、ロールバック記録 | 誤りがフリート全体へ急速に広がる |
Ladder Programの価値はデータ還流の設計で決まる
初期20パートナーは、ロボットメーカー、部品、現場を結ぶ出発点だ。参加者が増えれば、異なる身体から得たデータで共通表現を改善できる。反面、生産データの権利とセキュリティー、性能改善分の帰属、更新責任を合意できなければ、ネットワークの拡大とともに紛争も増える。
参加候補は、データをどの国、法人、クラウドに置くかを確かめる。原映像や設備情報をモデル学習へ使うのか、顧客が削除を求められるのか、更新を拒否したり旧版へ戻したりできるのかも契約に含めたい。「データネットワークへの参加」が顧客の統制権放棄を意味してはならない。
大規模フリートでは、脆弱性一件の影響も大きい。署名のないモデルを導入できない仕組み、部品版ごとの脆弱性・パッチ追跡、事故時に特定ロボット群だけを隔離する機能が、100万台構想の運用実体を左右する。
コーヒー作りとハノイの塔では復旧力を見る
多段階の仕事はモデルの計画能力を見せやすい。コーヒーを作る途中やハノイの塔を移す途中で物体位置を変えれば、決めた動きを再生するだけのシステムと、状況を理解して再計画するシステムを分けられる。
検証では成功映像を見るだけでなく、手順を一つ抜いたり、カップを動かしたりする。異常を検知する時点、前段階へ戻る方法、人の介入回数、全体の完了時間を記録する。ヒューマノイドとAMRで同じ「ブレイン」を使うなら、実際に共有するモジュールと身体ごとに再学習した部分も切り分けたい。
この試験は「汎用」を具体的な再利用率へ変える。共通モデルが作業計画の70%を担っても、下位制御とデータがすべて身体別なら統合費はなお大きい。正確な比率は、ベンダーのバージョン管理資料と反復試験で確認する必要がある。
3,000社の顧客とオープンソース計画は別々に検証する
約3,000社の顧客と20超の産業という同社の数字は、市場との接点を示す。ただし、現在の稼働顧客、有償顧客、案件期間、顧客当たり台数も開示されなければ、事業の深さは読めない。SEER公式ニュースセンターの四半期・事業発表で定義が変わっていないかも追いたい。
同社は2026年第4四半期にデータセットと評価基準を公開する計画も示した。まだ履行前の日程である。公開後はライセンス、データ構成、個人・顧客情報の除去、失敗例の比率、ベンチマークの再現性を確認したい。ファイル公開だけで、オープンなエコシステムが実証されたことにはならない。
企業の全体像はフィジカルAI企業エコシステム、仮想評価はロボットシミュレーター比較、現場配備の制約はロボット向けエッジAIで詳しく確認できる。SEERの構想を現実と認める基準は、100万という数字そのものではない。多様なロボットで安全な性能改善を反復し、その成果がパートナーへ還元されるかどうかだ。
よくある質問
SEER Roboticsはすでに100万台を配備したのか
配備していない。100万台は、Ladder Programのパートナーと2030年までに達成を目指す目標であり、現在の設置台数や確定注文ではない。
SEERの汎用ロボットブレインは巨大モデル一つで動くのか
同社はモデル、小脳、神経系の組合せとして説明する。作業理解と意思決定、運動実行、センサー・アクチュエーター接続を別の層で担う。
SEERのデータセットと評価基準はすでに利用できるのか
同社が示したのは2026年第4四半期の公開計画だ。範囲、ライセンス、品質は実際の公開後に確認する必要がある。
確認した公式資料
最終確認:2026年8月23日