SEER Robotics所说的“100万台机器人”不是当前安装量,而是计划与Ladder Program合作伙伴在2030年前部署100万台具身智能机器人。为此,公司不只要做一个大模型,还要同时建设负责判断的模型层、负责运动的小脑层、连接传感器和执行器的神经系统,以及把现场数据送回训练的数据网络。
100万台是2030年目标,不是现在的安装数量
SEER Robotics在WRC 2026的发布称,将通过Ladder Program与合作伙伴争取在2030年前部署100万台具身智能机器人,并公布了首批20家伙伴。目标和参与框架已经确认,但不代表100万台已经下单或在现场运行。
同一发布提到约3,000家客户、20多个行业以及适配400多种核心零部件的体系。这是公司口径下的生态规模。单个客户可能运营多台,也可能只有一个项目,不能把客户数直接换算成机器人数量或重复收入。SEER官网与不同时点发布中的客户数也可能不同,因此每个数字都要附上日期和定义。
| 数字 | 官方材料中的含义 | 错误解读 |
|---|---|---|
| 100万台 | 与伙伴争取在2030年前实现的部署目标 | 当前安装量或订单量 |
| 首批20家 | Ladder Program的第一批合作伙伴 | 20家客户都已签署量产合同 |
| 约3,000家 | WRC发布中的客户规模 | 3,000个付费集群都在同等运行 |
| 20多个 | 公司所称的适用行业范围 | 同一模型已在所有行业得到验证 |
| 400多种 | 核心零部件适配体系 | 所有版本组合均已兼容并完成安全认证 |
所谓通用机器人“大脑”,其实由模型、小脑和神经系统三层协作
SEER把机器人“大脑”分为模型、小脑和神经系统。模型层理解环境、规划任务并作出决策;小脑层把规划转成运动轨迹并稳定实时执行;神经系统层负责与传感器、关节和执行器通信的接口及协议。
这一区分来自机器人不同的时间尺度。“把托盘送到目的地”的计划可以相对慢地生成,但行驶中避人和修正轮速必须更快。即使上层模型推理迟缓或出错,下层控制和安全层也不应无条件执行不稳定命令。
因此不能把通用“大脑”理解成一个更大的AI模型。除任务理解外,实时控制周期、支持硬件、通信时延、安全停车和版本兼容必须共同工作,机器人才能在现场完成任务。
400多种零部件适配,要用兼容矩阵而不是一张名单验证
叉车、AMR、四足机器人和人形机器人的传感器与驱动器不同。即使接收同一命令,轮式速度控制和人形平衡控制的可复用范围也不同。连接400多种核心零部件的战略,意味着SEER想扩大对多种机器人本体的支持。
但零部件出现在名单上,不代表现场兼容已经完成。固件、驱动、通信周期、安全状态、标定值和长期供货都要匹配。换一个传感器后时延增加,或错误读取执行器扭矩边界,上层计划即使正确也会执行失败。
采购方不应只取得“支持/不支持”的回答,而应拿到机器人型号×零部件×固件×大脑版本的矩阵。新版本由谁重新验证、停产部件可以替换成什么,也应纳入总成本。

现场数据公司要把失败变成可治理的学习资产
SEER提出的数据体系依次覆盖采集、多源整合、治理、训练、评测和现场反馈。机器人停机或人工远程接管的片段,会被送回模型改进,形成闭环。
以叉车区分黑色和蓝色托盘为例,只演示颜色识别不够。托盘歪斜或人员进入通道时,鸟瞰图(BEV)感知如何变化?介入前后数据用什么标签保存?新策略是否损害原本擅长的任务?这些都要评估。
若把坏策略生成的偏置数据直接用于再训练,错误可能被放大。现场数据不能自动训练后直接上线,而应经过质量检查、安全评测、审批、限定部署和回滚门禁。
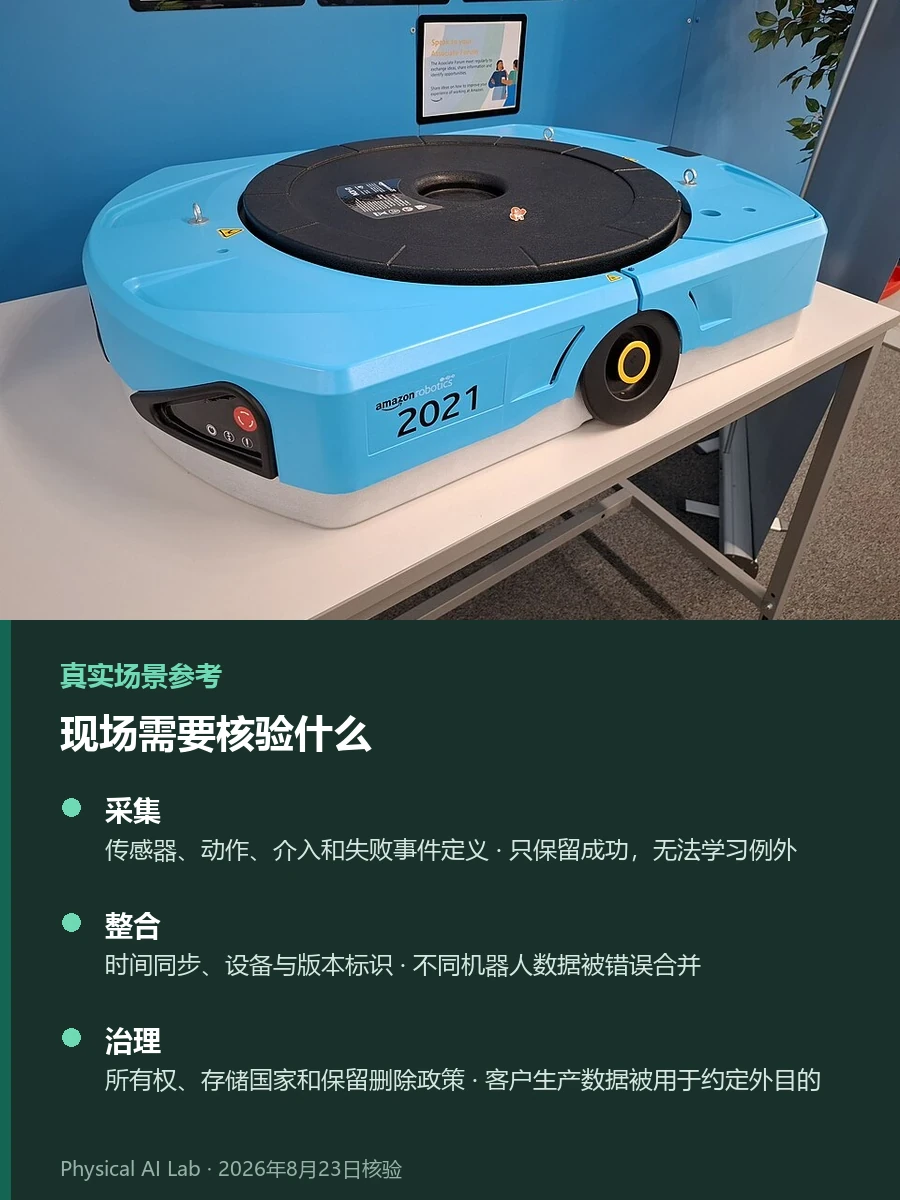
| 数据阶段 | 运营方应检查的文件 | 主要失败风险 |
|---|---|---|
| 采集 | 传感器、动作、介入和失败事件定义 | 只保留成功,无法学习例外 |
| 整合 | 时间同步、设备与版本标识 | 不同机器人数据被错误合并 |
| 治理 | 所有权、存储国家和保留删除政策 | 客户生产数据被用于约定外目的 |
| 训练与评测 | 基线模型、测试集和回归评测 | 新功能损害已有任务性能 |
| 部署与反馈 | 审批范围、分阶段部署和回滚记录 | 错误迅速扩散到整个机器人集群 |
Ladder Program能否形成价值,取决于数据怎样回流、收益怎样分配
首批20家合作伙伴把机器人制造商、零部件和现场连接起来。伙伴越多,越有机会用不同本体的数据改进共同表达;反过来,若生产数据权利、安全、改进成果归属和升级责任没有约定,网络越大,争议也会越大。
潜在伙伴应确认数据存在哪个国家、法人和云环境。原始视频与设备信息是否用于训练,客户能否要求删除,能否拒绝更新或回退旧版本,都应写入合同。加入“数据网络”不能等于放弃客户控制权。
大规模集群中,一个安全漏洞的影响也更大。是否禁止安装未签名模型,是否按零部件版本追踪漏洞与补丁,事故发生时能否只隔离特定机器人群,决定了100万台战略有没有运营基础。
咖啡和汉诺塔演示,真正要看的是中途出错后能否重规划
多步骤任务适合展示模型规划能力。制作咖啡或移动汉诺塔时,如果中途改变物体位置,就能区分只回放预设动作的系统,与理解局面后重新规划的系统。
验证者不应只看成功视频,可以故意漏掉一步或移动杯子,记录机器人何时发现错误、怎样回退、人工介入次数和总完成时间。若人形机器人和AMR声称共用同一“大脑”,还应区分实际共享模块与按本体重新训练的部分。
这类测试能把“通用”转化成具体复用率。即使共同模型承担70%的任务规划,若底层控制和数据都按本体单独开发,集成成本仍可能很高。准确比例应以供应商版本文档和重复测试为准。
3,000家客户与开源计划,需要分别核对活跃度和兑现情况
公司口径中的约3,000家客户和20多个行业,说明其市场触点;但要判断业务深度,还需活跃客户、付费客户、项目周期和每客户机器人数量。也要跟踪SEER官方新闻中心的季度与业务发布,确认定义是否变化。
公司还计划在2026年第4季度公开数据集和评测标准,这仍是尚未履行的日程。真正公开后,要检查许可证、数据组成、个人与客户信息清理、失败案例占比和基准可复现性。上传文件本身不能证明开放生态已经成立。
企业版图可见具身智能(Physical AI)企业生态,虚拟评测环境见机器人仿真器对比,现场部署约束见机器人边缘AI。判断SEER目标能否落地,不是看“100万”本身,而是多种机器人能否持续获得安全性能改进,且成果能回到合作伙伴。
常见问题
SEER Robotics已经部署100万台机器人了吗?
没有。100万台是Ladder Program计划与伙伴在2030年前实现的目标,不是当前安装量或确定订单。
通用机器人“大脑”就是一个大模型吗?
不是。SEER把它描述为模型、小脑和神经系统的组合,分别负责任务理解与决策、运动执行以及传感器和执行器连接。
SEER的数据集和评测标准已经可以下载了吗?
公司提出的是2026年第4季度公开计划。实际范围、许可证和质量要等资料上线后再核对。
已核验的官方资料
最后核对:2026年8月23日