機器人資料工廠是一個營運系統,收集示範、自主執行回合、介入和失敗,將其轉化為可追溯的回合,並將經過驗證的證據回饋到模型訓練和部署決策中。其產品不是原始影片;它是可用且受控的學習資料。
艱難的工作集中在介面上。攝影機和動作必須共享時間,機器人具身形態需要明確的結構描述,任務結果需要標籤,每個轉換流程都必須納入版本管理。否則,更大的資料集可能會悄悄地將不相容的單位、座標系、策略和成功定義結合起來。
本指南補充了 合成機器人資料指南 和 物理 AIPoC 框架。收集應遵循目前部署環境下的隱私、同意、安全和許可要求。
在收集更多資料之前,先設計回合
定義從任務請求到終止的一集,包括重置和結果。記錄觀察值、機器人狀態、動作、時序、任務文字、環境、操作員輸入和成功證據。資料集無法修復未定義的任務邊界。
在結構描述登錄中定義單位、座標系、影像慣例和動作語意。標記必填與選填欄位。結構描述變更應產生新版本和遷移記錄,而非無聲重新解讀。
時鐘對齊決定行為是否可學習
攝影機影格、本體感覺、指令、力訊號和控制狀態的到達速率和延遲各不相同。如果時間戳錯誤,訓練會將觀察與錯誤的動作配對,並根據誤導性的真實資訊評估策略。
使用通用時鐘或測量偏移,保留來源時間戳並記錄重取樣。注入已知運動以驗證對齊。在實際操作中監控掉影格、佇列延遲和抖動,而非假設標稱頻率。
具身後設資料可防止把不同機器人錯誤視為可直接對應
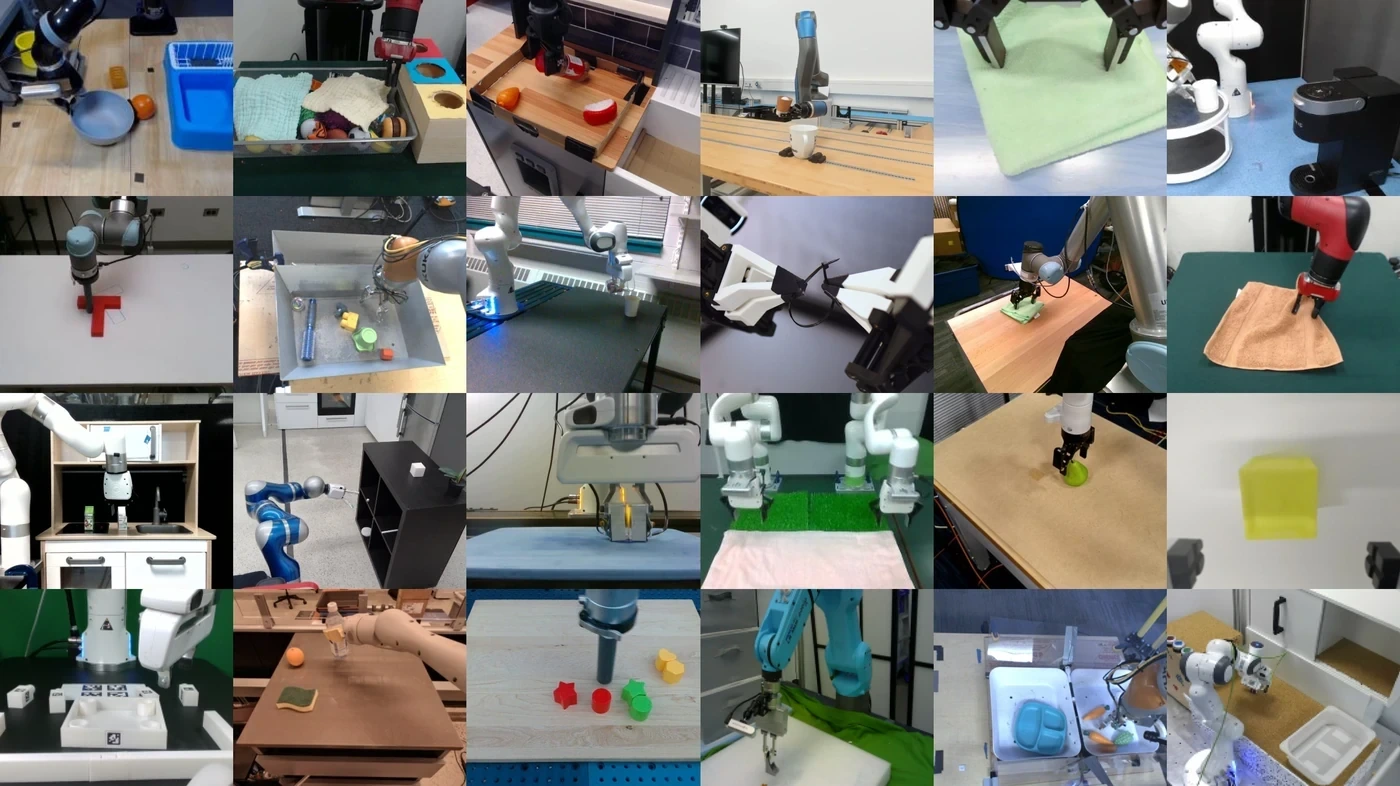
Open X-Embodiment 專案以統一的回合格式表示許多機器人資料集,同時保留資料集和動作空間細節。其公開材料展示了為何共享容器不會抹除硬體差異。
記錄機器人模型、關節、限制、夾爪、感測器、校正、控制器、韌體和動作解釋。七維動作向量可以表示絕對姿態、增量位姿或速度;這些在沒有明確適配器的情況下無法互換。
| 回合欄位 | 為什麼重要 | 缺失時的失效後果 | 質量檢查 |
|---|---|---|---|
| 時間戳 | 因果對齊 | 錯誤的監督 | 已知運動測試 |
| 具身 | 解釋狀態和動作 | 不安全轉移 | 資料模式與適配器測試 |
| 任務與結果 | 定義意圖和成功 | 模糊標籤 | 獨立驗證 |
| 校正 | 感測器對映到幾何體 | 系統性空間誤差 | 參考靶測試 |
| 策略來源 | 追溯行為來源 | 有偏差的評估 | 版本與雜湊 |
展示中包含操作員選擇和隱藏的修正
遙操作和動覺教學能快速捕捉成功的行為,但操作者在風格、速度和恢復上有所不同。示範可以包括暫停、攝影機搜尋或學習者理解為預期行為的糾正。
記錄操作員身份或協議、介面延遲及是否發生援助。儲存失敗和恢復的事件。比較多位專家,詢問收集的軌跡是否覆蓋自治策略實際存取的狀態。
資料整理應保留有價值的困難樣本
刪除損壞的檔案、破損的時序和不可能出現的標籤,但不要逐一清理所有硬案例。瀕於失敗、恢復和異常物件通常包含了部署穩健性最有價值的資訊。
使用自動檢查範圍、連續性、重複和缺失欄位,隨後進行抽樣人工稽核。指定拒絕理由。資料整理決策應能在置頂的原始資料快照中復現。
標籤需要明確定義與一致性量測
成功、抓取品質、接觸、介入和失敗原因需要書面定義。對於主觀標籤,應由多位標註者處理並量測一致性。對模糊案例升級處理,而非強制確定性。
模型輔助標記可以加快工作速度,但會引入系統性錯誤。按任務、地點和預測信心分數抽樣,然後對照人工或儀器證據進行審計。保留標記器和工具版本。
資料集版本必須保護評估分割
建立不可變的資料集釋出,包含來源回合 ID、結構描述、轉換流程、過濾器和授權條款。內容雜湊使得復現訓練和迴歸調查成為可能。保留受控資料的刪除和存取控制程式。
按回合群組、物件、環境、時間或地點切分,避免近似重複序列洩漏到評估中。隨機切分影格可能讓模型看似具有泛化能力,實際上卻在訓練時看過幾乎相同的軌跡。
| 資料工廠指標 | 它揭示了什麼 | 誤導性的捷徑 | 營運用途 |
|---|---|---|---|
| 有效回合率 | 收集可靠性 | 僅限原始時間 | 修復捕獲流水線 |
| 標註一致性 | 定義質量 | 標籤數量 | 精細分類 |
| 留出測試成功率 | 泛化能力 | 訓練損失 | 釋出決定 |
| 故障覆蓋 | 部署相關性 | 僅成功資料 | 採集優先順序 |
| 追溯回合所需時間 | 治理成熟度 | 儲存體積 | 事件反應 |
訓練應該保留一條回溯到每一集的路徑
記錄資料集版本、抽樣權重、預處理程式碼、模型設定、隨機種子和檢查點。如果策略失敗,工程師應追蹤哪些示例和變換塑造了該行為。
平衡任務,同時不抹去其真實操作分佈。對罕見失敗進行過度取樣可以提升學習效果,但會扭曲機率。評估平衡診斷集和代表性部署集。
部署回饋關閉了資料迴圈
記錄實際運行機器人的任務請求、策略版本、信心、介入、失敗和已驗證結果。優先在故障嚴重度、頻率或業務影響較高的地方收集,而非最易收集資料的地方。
使用影子評估和金絲雀部署來驗證新策略。按任務和條件比較效能退化,並保留回滾能力。只有當每個週期都改善留出測試與實際營運證據時,資料飛輪才算健康。
治理是生產架構的一部分
定義資料所有權、同意、保留、存取、加密、匯出和刪除。工作場所影片可以捕捉人員、標籤和專有流程。開放資料集許可可能因程式碼、影像和貢獻來源而異。
在培訓和釋出前審計權限,並隔離受限資料。事件流程應辨識受影響的事件及其衍生模型。可擴充的工廠使合規和可追溯性成為常規,而非人工緊急。
評估“機器人資料工廠:收集、治理、訓練與部署回饋”時,還應儲存模型版本、機器人設定、校正檔案、測試日期和全部試驗記錄。
- 在擷取前定義回合和結構描述。
- 測量時間戳和校正質量。
- 保留具身資訊和策略來源。
- 對資料、標籤、轉換流程和切分方式進行版本管理。
- 將已驗證的現場失效資料輸入有界的收集計劃。
常見問題
什麼是機器人資料工廠?
它是收集、驗證、標記、版本管理、培訓和回饋系統,將機器人操作轉化為受控的學習片段。
機器人資料多是不是總是更好?
不會。不正確的時序、模糊的動作、資料洩漏和不具代表性的收集,都可能使較大的資料集比較小的可追溯資料集更糟糕。
跨機器人資料需要哪些後設資料?
記錄具體機體、感測器、校正、動作語意、單位、座標系、控制器和任務結果,以便適配器正確解讀每個片段。
失敗的機器人回合應該被保留嗎?
是的,只要這些示範有效且受監管。失敗和恢復顯示,成功展示中可能從未出現這些狀態。
如何防止評估洩漏?
按回合、物件、環境、地點或時間妥善切分,去除相關序列的重複項,並保留不可變的留出測試集。
資料治理說明
機器人資料可能包含個人、專有或安全敏感資訊。應用目前的同意、許可、存取、儲存和安全要求,並保持從模型輸出到受治理的來源回合的可追溯路徑。