Seeing Machines的Physical AI Platform并不是只判断“前方有人”的障碍物检测器。它尝试解释人的姿态、视线、注意力和行为状态,预测下一步动作或风险,再向机器人的导航、物品交接和安全监督提供信号。平台面向多种机器人形态,但不能替代整机的功能安全设计或认证。
从See到Act:系统要持续观察、理解、预测并更新动作
Seeing Machines机器人官方页面把平台分成四步:See检测人员、物体和3D空间;Understand解释视线、注意力、活动与交互情境;Anticipate预测人员路径和新风险;Act把结果交给安全动作建议或机器人功能。
虽然名称有先后,真实系统会持续往返更新。若有人把手伸向货架,机器人不能只看手的位置,还要重新判断对方是在接物品、只是经过,还是失去平衡。每一帧新画面都会改变预测和动作。
| 层级 | 官方页面描述的功能 | 现场必须核对的边界 |
|---|---|---|
| See | 人员与物体检测、姿态与运动、3D占用和危险区 | 遮挡、逆光和拥挤时能否保持检测 |
| Understand | 视线、注意力、情绪、活动状态和接物准备 | 是否会凭单一信号断定人的意图 |
| Anticipate | 路径、跌倒或不稳及新风险预测 | 是否同时输出预测时域和不确定性 |
| Act | 安全动作建议、移动与操作辅助、远程例外处理 | 安全停车和最终控制是否相互独立 |
See漏掉一个人,后面的判断再精细也没有意义
知道机器人前方“有人”还不够。系统要实时估计对方看向哪里、手脚位置以及可能占据的空间。工人可能被纸箱遮挡,医院患者会被床栏挡住一部分,家庭里儿童和宠物又可能突然进入画面。
只看平均检测率很危险。系统在明亮正面画面中表现良好,不代表逆光、反光背心、低照度、人群或相机抖动时不会出现严重时延。部署测试应改变遮挡程度、光线、人数和相机位置;除漏检帧数外,还要记录重新找到人员并恢复正常状态所需时间。
Seeing Machines称平台采用模块化、与硬件和传感器无关的架构。这是一种设计方向,不代表所有摄像头和计算设备上的性能相同。镜头视场角、分辨率、帧率、安装高度和标定流程改变后,输入也会改变。
Understand判断当前状态,Anticipate预测下一步变化
Understand回答的更接近“这个人现在在做什么”:视线和注意力在哪里,是否准备接物品,是否意识到机器人。Anticipate再向前一步,预测双方路径是否会重叠、跌倒风险是否增加、是否会形成新的危险区。
两者都输出概率结果。看向机器人不等于确定愿意配合,伸手也不等于已经准备好承重。系统应结合多个信号的时间变化;不确定性较高时,应选择停下或把任务交给人处理。
Seeing Machines Human Factors说明称其基于20多年实时人类行为研究,机器人页面则强调25年以上的人因研究、嵌入式AI和生产工程经验。这些经历说明数据与研究积累,却不能替代机器人功能在具体客户现场的准确率或认证结果。

Act可以提供动作信号,但不是急停回路
Act层包括安全动作建议、导航和操作支持、考虑人的物品交接、视觉-语言-动作模型、遥操作与例外处理以及动作门控。这是感知结果进入机器人真实动作的环节。
“建议安全动作”与“经过认证的安全控制”职责不同。模型可以预测人员靠近并建议降速,却不能自动取代功能安全传感器、控制器和急停回路。即使模型漏检或通信中断,也必须有独立防护层把机器人送入安全状态。
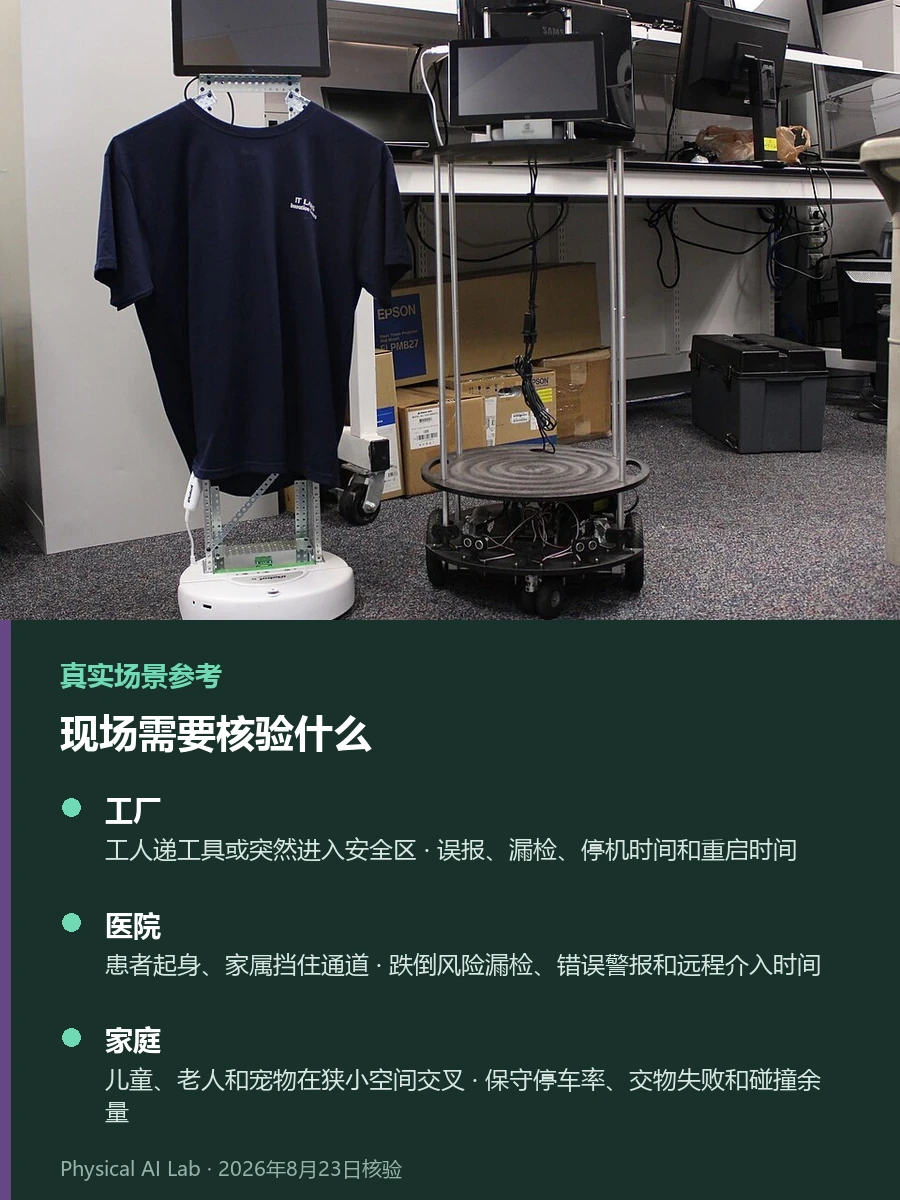
以病房送药为例:患者起身、家属横穿机器人前方时,平台可解释姿态和动线,降低接近速度或把例外交给远程人员;但制动距离和防碰撞仍应由机器人本体的安全设计负责。
工厂、医院、家庭会暴露同一模型的不同弱点
人员理解功能在不同空间的失败代价不同。工厂里的频繁误报会造成停产;医院更担心漏检和隐私泄露;家庭用户与环境差异极大,超出训练范围的场景更常见。
| 环境 | 必须纳入的测试场景 | 失败时应查看的指标 |
|---|---|---|
| 工厂 | 工人递工具或突然进入安全区 | 误报、漏检、停机时间和重启时间 |
| 医院 | 患者起身、家属挡住通道 | 跌倒风险漏检、错误警报和远程介入时间 |
| 家庭 | 儿童、老人和宠物在狭小空间交叉 | 保守停车率、交物失败和碰撞余量 |
| 物流 | 推车与工人从多个方向移动 | 路径预测误差、集群拥堵和绕行成功率 |
物品交接尤其考验细节。用户伸手与真正准备承重之间存在时间差。太早松手可能造成损坏或受伤,太晚则可能拉扯人的手,因此必须把接物准备判断与力控、触觉控制一起测试。
边缘处理与Managed AI必须同时设计隐私边界
Seeing Machines提出在时延和功耗约束下把模型部署到边缘,用合成数据补充罕见或危险场景,再用Managed AI监控机器人集群。远程事件复核和OTA改进对多机运营有价值,也带来人的视频和行为数据流向何处的问题。
设施运营方应区分原始视频与事件特征,规定保存地点、可访问人员、保存期限和删除流程。远程操作员能看到哪些画面,哪些数据可用于模型改进,都应写入合同;还要核对数据是否跨境传输,以及客户能否拒绝把数据用于训练。
部署测试不能只给一个准确率,要说明错误会往哪个方向发展
机器人OEM或系统集成商需要的不是单一准确率,而是一组完整信息:输入传感器条件、处理时延、预测时间范围、误报与漏检、置信度输出以及安全门控的失效模式。
测试不能止于整洁的演示区。应部分遮住相机、降低光线,让人员突然改向或掉落物品;观察模型不确定时是否停车,错误预测是否会传到底层控制,以及远程介入后多久恢复正常任务。
基础架构可继续阅读具身智能(Physical AI)的含义与边界,模型结构见机器人基础模型,合成环境与实体设备的差异见Sim-to-Real核心概念。Seeing Machines平台的价值不在“读懂人心”的宣传语,而在于能否在拥挤现场更早发现风险,并在判断错误时安全退让。
常见问题
Seeing Machines能准确确定人的意图吗?
不能把它理解为确定人的想法。平台依据姿态、视线、注意力和行为情境,对下一步移动和交互可能性做概率估计。
接入这套平台后,还需要独立安全传感器吗?
需要。人员认知和动作建议不能取代功能安全传感器、制动控制、急停以及现场风险评估。
换一款摄像头或机器人,识别效果会保持不变吗?
不一定。公司强调模块化和传感器无关方向,但实际支持的传感器、计算设备、机器人接口和性能范围仍要按集成规格验证。
已核验的官方资料
最后核对:2026年8月23日