AgiBot World Challenge 2026 結合線上自動評測與維也納的實機決賽。關鍵不只是模擬排名,而是在 G2 人形機器人上檢查長時間任務穩定度、物理適應與失敗復原。
AgiBot 挑戰賽實際評測了哪些內容
AgiBot 官方回顧列出 EWMBench、Genie Sim Benchmark、R2A、世界模型賽道、超市場景的實機任務與優勝隊伍。由於資料出自主辦方,比起沒有佐證的跨基準優越宣稱,這些資訊更適合用來理解評測設計本身。
AGIBOT 3月發布的賽事說明指出,Reasoning to Action賽道包含線上模擬與線下實機競賽階段,World Model賽道則只有線上競賽階段。因此,線上評估結果與實機評估結果的直接比較應限定於Reasoning to Action賽道,不應延伸到其他賽道。
| 階段 | 已確認內容 | 可觀察能力 |
|---|---|---|
| 線上 | 自動評測與標準指標 | 可重現性與比較 |
| 線下 | G2 實機決賽 | 接觸與穩定度 |
| 真實任務 | 超市場景的移動操作 | 導航、揀取與搬運 |
排名落差可能指出模擬中缺少的物理條件
可重現的自動評測有助於比較隊伍,實機決賽則會暴露接觸動力學與感測誤差。兩套排名若大幅變動,可能代表模擬漏掉重要物理變因,或策略建立在脆弱假設上。
可重複的實體 AI 仍需要感測同步、狀態估測、規劃、底層控制、安全限制與復原串成一條完整鏈。
把線上排名與實機耐久、泛化能力放在一起比較
應確認機器人連續完成多少次任務、人員何時介入,以及停止後如何恢復。實機決賽不應只呈現一次成功。
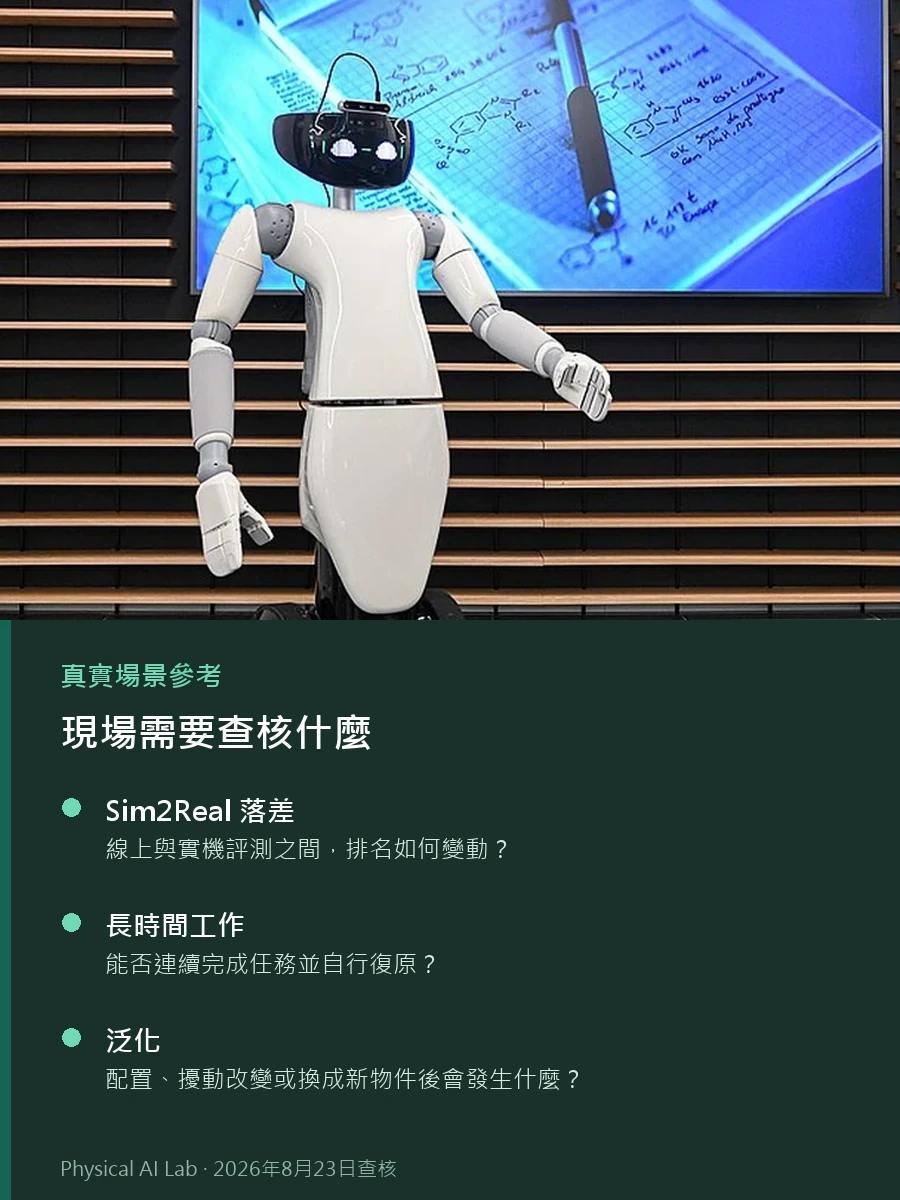
| 檢查項目 | 應提出的問題 |
|---|---|
| Sim2Real 落差 | 線上與實機評測之間,排名如何變動? |
| 長時間工作 | 能否連續完成任務並自行復原? |
| 泛化 | 配置、擾動改變或換成新物件後會發生什麼? |

基準分數的有效範圍,不會超出它測過的分布
新物件、不同機器人、更長營運時間與安全驗證,都需要另外提供證據。不能把基準結果擴張到它沒有測試的任務與分布。
目前主要來源是官方回顧。獨立重現與客戶場域資料出現後,應用新證據更新判斷。
如何解讀模擬與實機之間的差距
可搭配實體 AI 是什麼、Sim-to-Real 核心概念與機器人基礎模型閱讀。本文加入截至 2026 年 8 月的基準與實機訊號。
實機決賽真正提供的價值
AgiBot World Challenge 2026 把線上自動評測接到維也納實機決賽。最有用的證據,是可重現模擬分數與真實硬體反覆表現之間的差異。
常見問題
贏得 AgiBot 挑戰賽,能證明具備商用成熟度嗎?
不能。勝出只證明在挑戰賽任務內表現較佳;商用仍要有訂購方式、付費部署、反覆客戶資料與維修支援。
AgiBot 的線上排名與實機排名為什麼會不同?
真實硬體會帶入接觸、延遲、感測誤差、磨耗與環境變化,而自動基準不一定能完整模擬。
AgiBot 基準結果要具備哪些條件才容易重現?
應公開任務定義、評測程式碼、模型與設定版本、隨機種子、硬體配置、人員介入規則,以及所有測試紀錄。
已查核的官方資料
最後查核:2026年8月23日