Seeing Machines 的Physical AI Platform不只是發現「前面有人」的避障偵測器。它試圖理解姿勢、視線、注意力與行為狀態,預測下一步動作或風險,再把訊號交給機器人的導航、物品交接與安全監督。平台想支援多種機器形態,卻不能取代整機功能安全設計或認證。
從 See 到 Act,不是單向流程,而是持續更新的回饋迴路
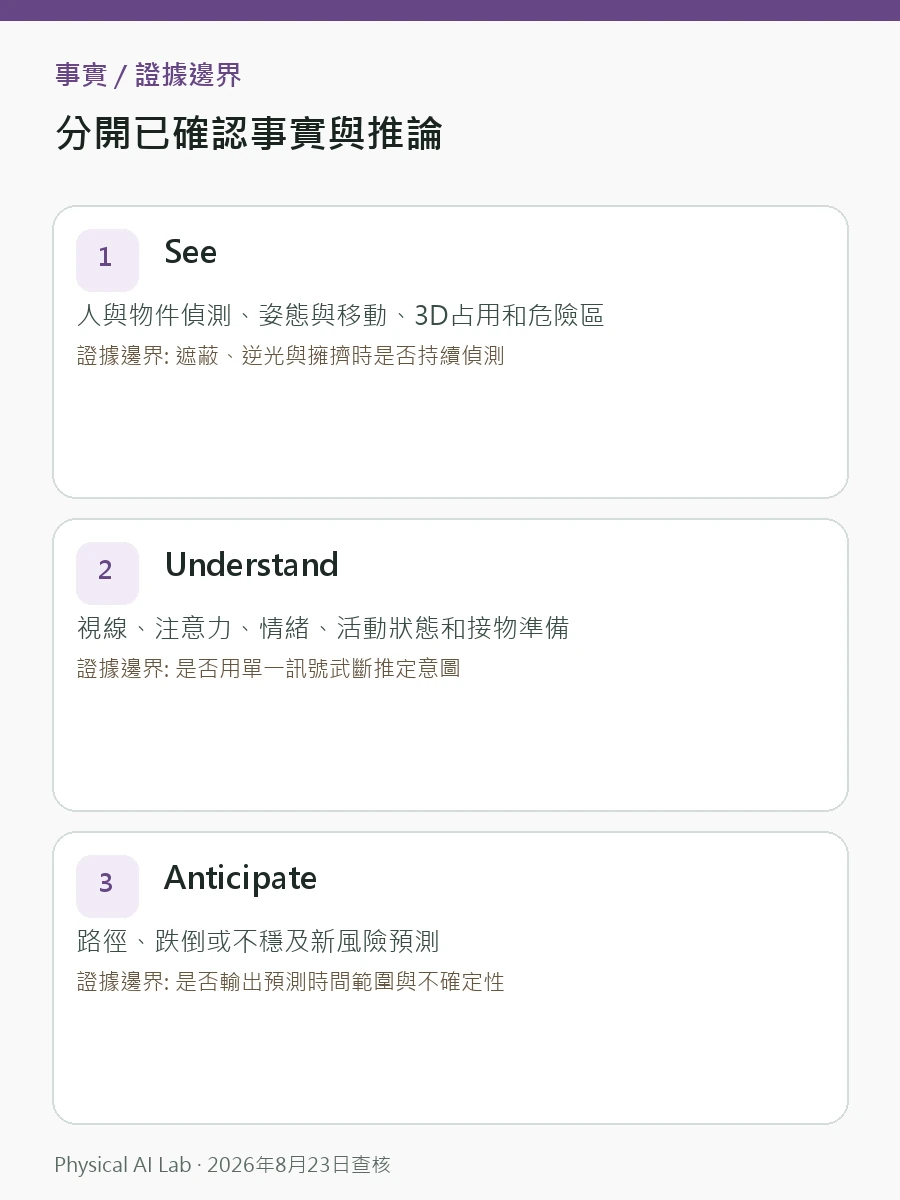
Seeing Machines機器人官方頁面將平台拆成四步:See負責偵測人、物件和3D空間;Understand解讀視線、注意力、活動與互動情境;Anticipate預測人的路徑和新風險;Act則把結果送給安全動作建議或機器功能。
名稱雖有順序,實際運作必須來回更新。當有人把手伸向貨架,機器不能只記住手的位置,還要重新判斷對方要接物、只是經過,或正在失去平衡;每一幀新畫面都可能改變預測與動作。
| 層級 | 官方描述的能力 | 導入時必查的界線 |
|---|---|---|
| See | 人與物件偵測、姿態與移動、3D占用和危險區 | 遮蔽、逆光與擁擠時是否持續偵測 |
| Understand | 視線、注意力、情緒、活動狀態和接物準備 | 是否用單一訊號武斷推定意圖 |
| Anticipate | 路徑、跌倒或不穩及新風險預測 | 是否輸出預測時間範圍與不確定性 |
| Act | 安全動作建議、移動操作支援和遠端例外處理 | 安全停車與最終控制是否獨立 |
感知階段若漏掉一個人,後面的推論再細也無法補救
知道前方「有人」還不夠,系統要即時估測對方視線、手腳位置和可能占用的空間。工人可能被紙箱擋住,病患部分身體藏在床欄後,家中的兒童與寵物又會突然闖入畫面。
平均偵測率容易掩蓋危險。明亮、正面畫面表現良好,不代表逆光、反光背心、低照度、人群或相機晃動時沒有嚴重延遲。部署驗證應改變遮蔽、光線、人數與相機位置,除了漏掉幾幀,也要記錄重新找到人並回到正常狀態的時間。
Seeing Machines宣稱平台採模組化、硬體與感測器無關架構。這是設計方向,不表示每款相機和運算設備都有相同性能;視角、解析度、幀率、安裝高度和校正流程一變,模型輸入也跟著變。
Understand 解讀當下,Anticipate 預測接下來會發生什麼
Understand較像回答「這個人現在在做什麼」:視線與注意力在哪裡、是否準備接物、是否察覺機器。Anticipate再往前預測雙方路徑會不會重疊、跌倒風險是否上升,以及新的危險區可能出現在哪裡。
兩層給出的都是機率,不是確定答案。看向機器不代表願意配合,伸手也不等於已準備承重。系統應讀取多種訊號的時間變化;不確定性過高時,選擇停下或轉交人員會更穩妥。
Seeing Machines Human Factors說明提到20多年即時人類行為研究;機器人頁面則強調25年以上的人因研究、嵌入式AI和生產工程經驗。這代表研究與資料累積,不能替代特定客戶場域的準確率或認證結果。

Act 能提供動作訊號,但不是緊急停止迴路
Act涵蓋安全動作建議、導航與操作輔助、考量人的物品交接、視覺語言動作模型、遙操作、例外處理和動作閘門,讓認知結果能影響真實機器行為。
「建議較安全的動作」和「經認證的安全控制」責任不同。模型可以預測人員接近並建議減速,卻不能取代功能安全感測器、控制器與急停。模型漏偵測或通訊中斷時,仍須有獨立防護把機器送入安全狀態。
病房送藥是典型例子:病患起身或家屬橫越路線時,平台可依姿態和動線降低接近速度,或把例外交給遠端人員;但煞停距離與防撞仍是機器本體安全設計的責任。
工廠、醫院與家庭,會放大同一模型的不同弱點
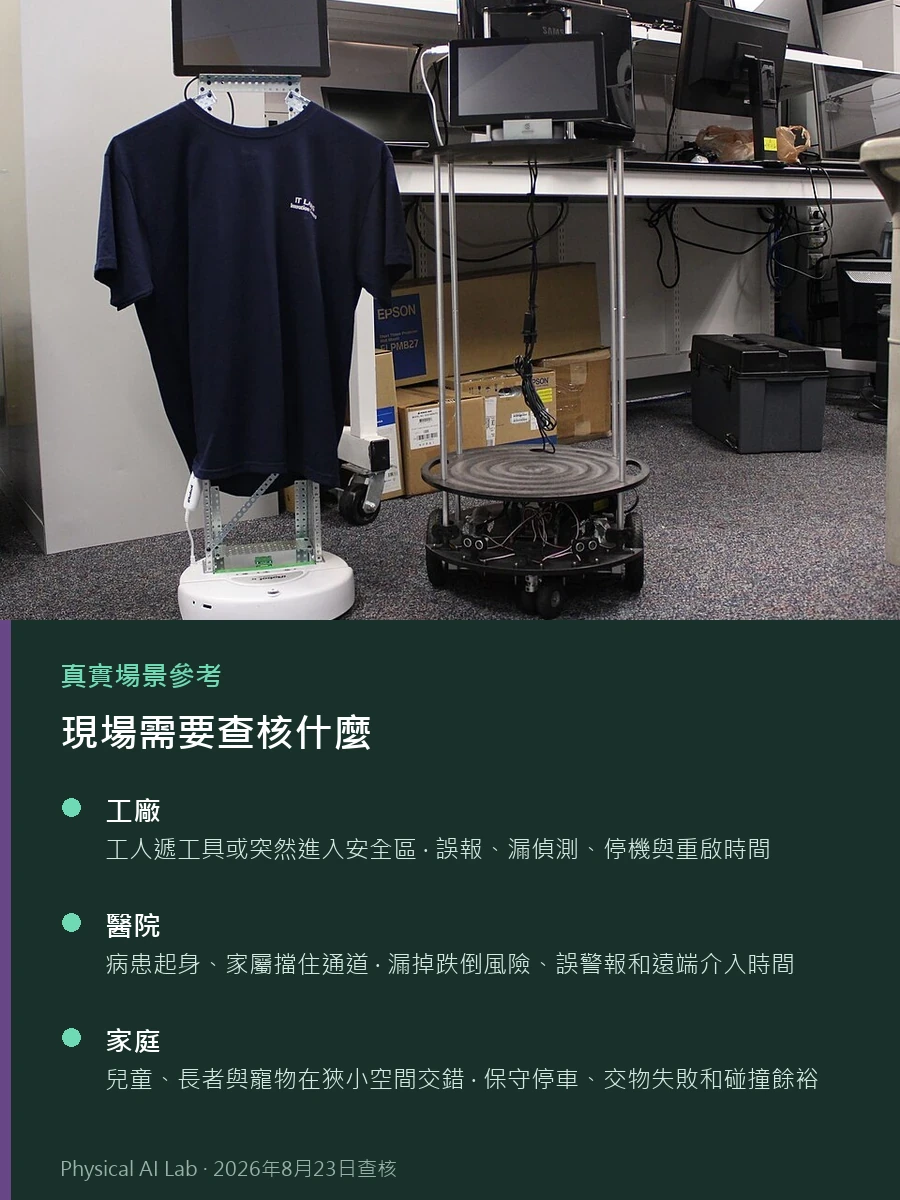
在不同空間,人員理解失誤造成的成本不同。工廠的誤報可能頻繁停線;醫院更怕漏偵測與隱私外洩;家庭的使用者和環境差異大,超出訓練範圍的情境更常出現。
| 環境 | 測試必須涵蓋 | 失敗時要查看 |
|---|---|---|
| 工廠 | 工人遞工具或突然進入安全區 | 誤報、漏偵測、停機與重啟時間 |
| 醫院 | 病患起身、家屬擋住通道 | 漏掉跌倒風險、誤警報和遠端介入時間 |
| 家庭 | 兒童、長者與寵物在狹小空間交錯 | 保守停車、交物失敗和碰撞餘裕 |
| 物流 | 推車與工作人員從多方向移動 | 路徑預測誤差、機群壅塞和繞行成功率 |
物品交接更考驗細節。伸手和真正準備承重之間有時間差;太早放開會損壞物品或傷人,太晚則可能拉扯手部。因此,接物準備判讀必須和力控、觸覺控制一併驗證。
邊緣處理與Managed AI要同步設定隱私邊界
Seeing Machines提出在延遲與功耗限制下把模型放到邊緣端,以合成資料補足罕見或危險情境,再由Managed AI監看機群。遠端事件覆核與OTA改善有利於多機營運,也同時帶來人的影片與行為資料流向問題。
設施營運者應區分原始影片和事件特徵,明訂保存地點、可存取人員、期限與刪除程序。遠端操作者能看到哪些畫面、哪些資料可拿去改善模型,都要寫進合約;跨境傳輸和客戶拒絕訓練使用的權利也要查清。
部署驗收要說明誤差方向,不能只給一個準確率
機器人OEM與系統整合商需要一組完整條件:輸入感測器、處理延遲、預測時間窗、誤報與漏偵測、信心分數,以及安全閘門如何失效。單一準確率無法回答系統會往哪個危險方向錯。
測試也不能停在整齊展示區。部分遮住相機、降低照明,讓人突然轉向或掉落物件,再觀察模型不確定時會不會停車、錯誤預測是否一路傳到底層控制,以及遠端介入後多久回到原工作。
基礎架構可從實體 AI(Physical AI)的定義與邊界開始,模型部分參考機器人基礎模型,合成環境與實體設備差異見Sim-to-Real核心概念。平台價值不在「讀心」,而是能否提早察覺擁擠場域風險,判斷錯誤時仍安全退讓。
常見問題
Seeing Machines能精確知道人的意圖嗎?
不能把它理解成確定人的想法。平台依姿勢、視線、注意力與行為情境,對下一步移動和互動機率進行估計。
接入平台後,還需要獨立安全感測器嗎?
需要。人員認知與動作建議不能取代功能安全感測器、煞停控制、急停和場域風險評估。
換一款相機或機器人,辨識結果會維持不變嗎?
不一定。公司強調模組化和感測器無關方向,但實際支援的感測器、運算設備、機器介面與性能範圍仍須按整合規格驗證。
已查核的官方資料
最後查核:2026年8月23日