오픈 로봇 데이터셋 비교 2026: Open X-Embodiment·DROID·BridgeData V2·AgiBot World·LeRobot
Open X-Embodiment·DROID·BridgeData V2·AgiBot World·LeRobot은 규모만으로 비교할 수 없다. 로봇 형태, 행동 표현, 카메라, 라이선스와 재생 가능성을 작업 요구에 맞춰야 한다.
Open X-Embodiment·DROID·BridgeData V2·AgiBot World·LeRobot은 규모만으로 비교할 수 없다. 로봇 형태, 행동 표현, 카메라, 라이선스와 재생 가능성을 작업 요구에 맞춰야 한다.
로봇 공간 추론 평가는 점을 가리키는 능력, 3D 객체 위치, 여러 시점의 일관성, 행동 뒤 성공 판정을 따로 측정해야 한다. 하나의 평균점수로 합치면 좌표 오차와 의미 오판, 실패 감지를 구분할 수 없다.
월드모델은 가림 뒤 물체·접촉·실제 척도·긴 행동·다른 행위자의 반응에서 조용히 틀릴 수 있다. 작은 반례 장면과 안전 폴백으로 실패를 먼저 측정해야 한다.
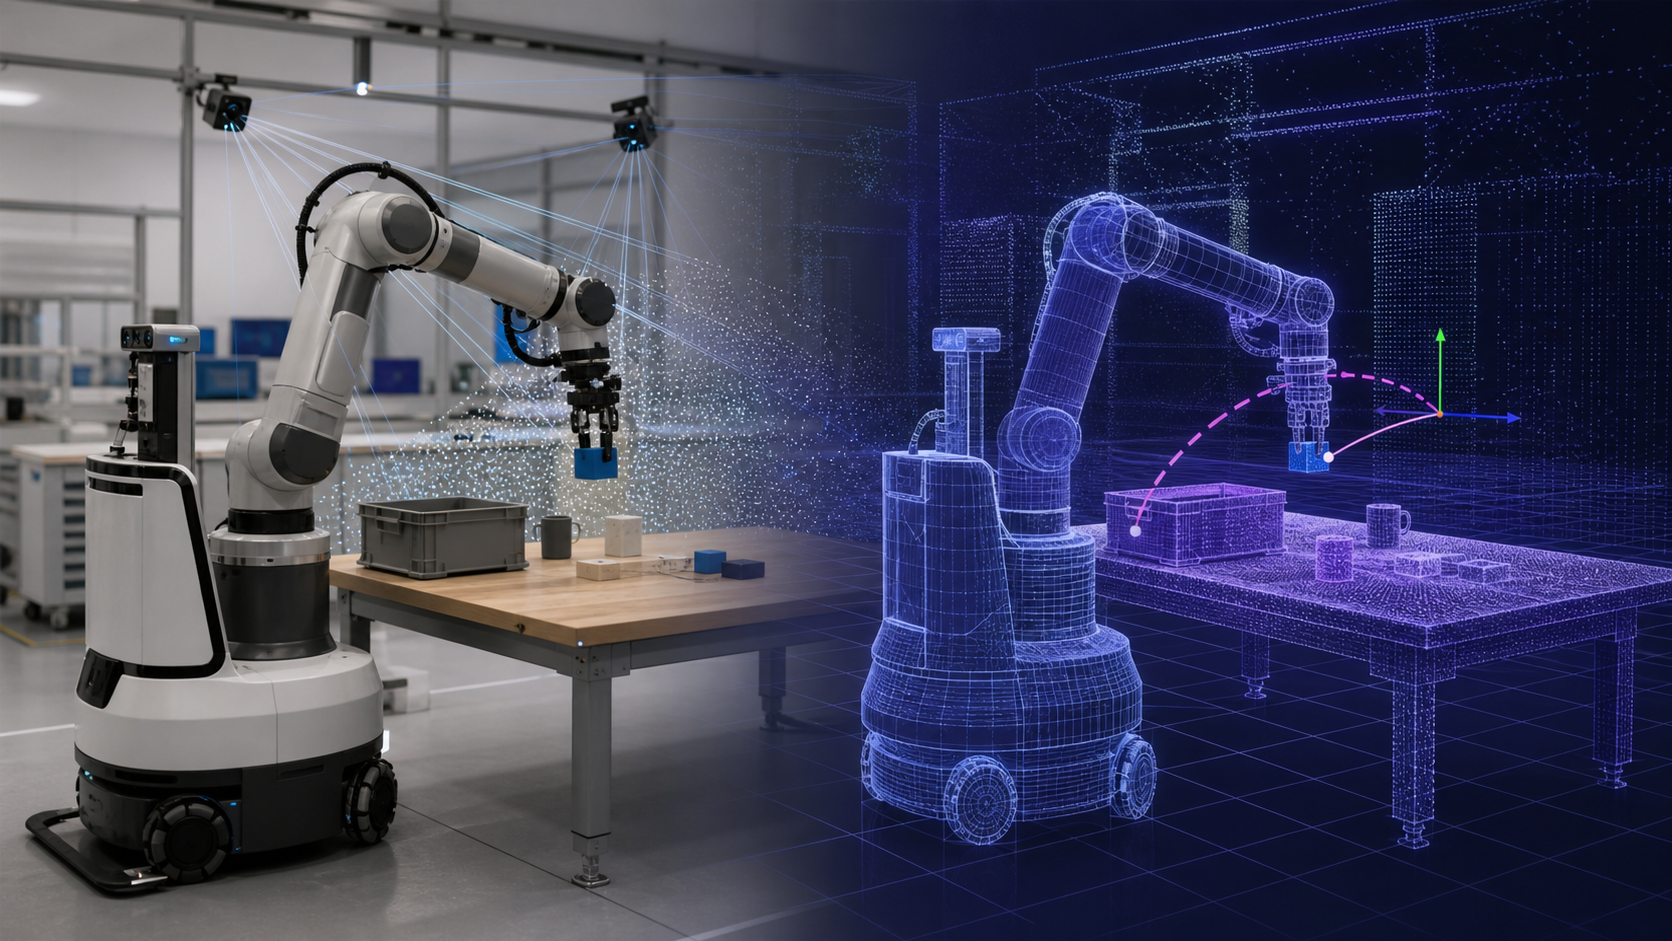
Action-Conditioned World Model과 MPC는 현재 관측에서 후보 행동의 결과를 예측하고, 목표에 가까운 첫 행동만 실행한 뒤 다시 계획하는 구조다. 성능은 모델·탐색·안전제약의 공동 결과다.
Real-to-Sim-to-Real은 실제 장면을 3D로 복사해 정책을 한 번 훈련하는 절차가 아니다. 측정·자산화·물리 보정·훈련·실물 잔차 회수의 반복 폐루프다.
VGGT는 영상에서 3D 기하를 복원하고 SpatialLM은 점군을 방·벽·문·물체의 구조로 해석한다. 둘을 같은 모델로 비교하기보다 연속 파이프라인의 입력·오차·인수 기준으로 봐야 한다.
깊이맵·포인트맵·가우시안 스플랫·메시는 서로 바꿔 쓰는 3D 파일 형식이 아니다. 로봇이 거리를 재고 충돌을 피하며 장면을 보여 주는 업무마다 필요한 표현과 검증법이 달라진다.
Spatial Intelligence는 3D 지도를 예쁘게 만드는 기능이 아니다. 로봇이 좌표·거리·가시성·지지·도달가능성을 표현하고 목표에 맞는 행동을 고른 뒤 결과를 다시 확인하는 공간 추론 능력이다.
V-JEPA·Cosmos·Genie는 모두 월드모델로 불리지만 같은 상품이나 같은 출력물을 만드는 모델이 아니다. 잠재표현 예측, 조건부 영상 생성, 상호작용 환경 생성을 입력·출력·행동조건·소비자별로 구분해야 한다.
자율 드릴링 로봇의 가치는 분당 천공 수가 아니라 BIM 좌표를 현장 기준점에 맞추고, 장애물·분진·재천공을 거쳐 검증된 완공기록으로 돌려보내는 전체 흐름에서 결정된다.