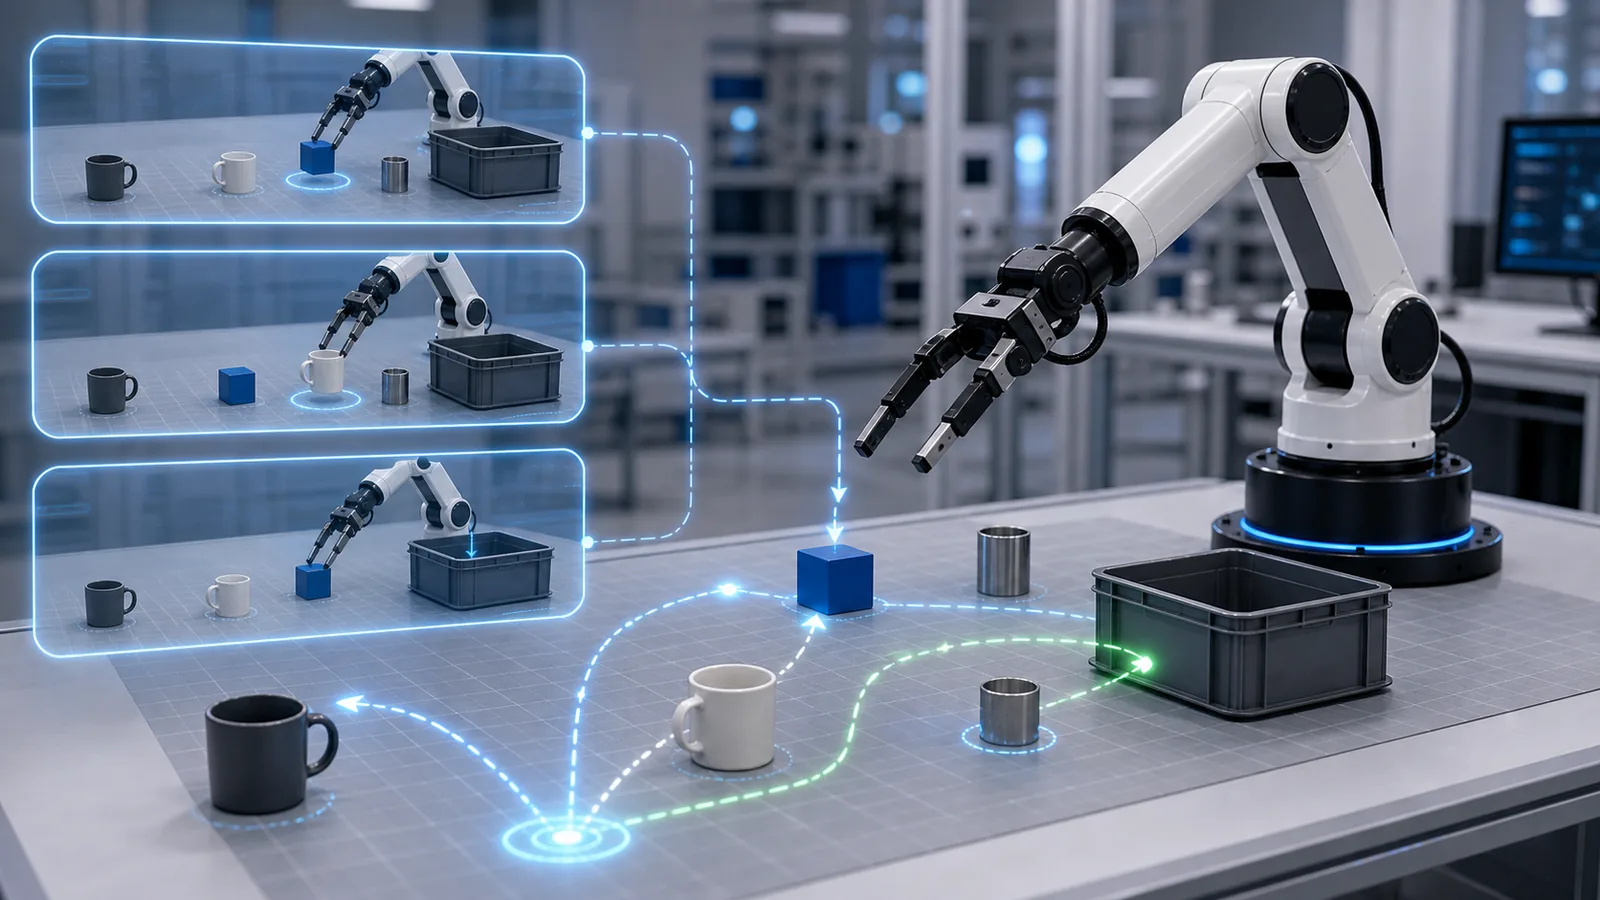
월드 모델(World Model)은 로봇이 지금까지 관찰한 장면과 자신의 행동을 바탕으로 다음 상태가 어떻게 달라질지 예측하는 내부 모델입니다. 컵을 보았다는 사실만 알아내는 데서 그치지 않고, 손을 어느 방향으로 움직이면 컵이 들릴지, 밀릴지, 기울어질지를 가늠하는 쪽에 가깝습니다. 다만 모든 로봇이 별도의 월드 모델을 가져야 하거나, 움직일 때마다 여러 미래를 화면처럼 생성해야 하는 것은 아닙니다.
피지컬 AI의 흐름에서 월드 모델은 보고, 판단하고, 움직이는 과정 사이를 잇습니다. 관찰을 현재 상태로 정리하고, 행동이 그 상태를 어떻게 바꿀지 예측해 학습이나 행동 선택에 쓰는 것입니다.
한 장의 사진보다 ‘무엇이 어떻게 변하는가’가 중요하다
카메라 한 프레임만으로는 컵이 비어 있는지, 이미 미끄러지고 있는지, 로봇 손이 어느 속도로 다가가는지 모두 알기 어렵습니다. 설계에 따라 월드 모델은 최근 관찰의 흐름에 관절 위치, 속도, 힘이나 촉각 같은 정보를 함께 쓰고, 작업에 필요한 상태로 압축할 수 있습니다. 이렇게 압축된 표현을 잠재 상태(latent state), 과거를 요약한 정보를 이력 또는 은닉 상태(hidden state)라고 부릅니다.
그다음 질문은 “다음 장면이 무엇일까?”가 아니라 “이 행동을 하면 다음 상태가 어떻게 될까?”입니다. 2018년 World Models 연구의 기억 모델은 현재 잠재 상태와 이력뿐 아니라 행동까지 조건으로 받아 다음 잠재 상태의 확률분포를 예측했습니다. 같은 컵 장면이라도 손을 닫는 행동, 옆으로 미는 행동, 가만히 있는 행동은 서로 다른 다음 상태를 만들어야 하기 때문입니다.
이 점이 일반적인 비디오 이어 그리기와 행동 조건부 예측(action-conditioned prediction)을 가르는 실용적인 기준입니다. 앞 장면이나 텍스트에서 그럴듯한 후속 영상을 만드는 능력은 표현 학습이나 합성 데이터 생성에 쓸 수 있습니다. 하지만 로봇 제어에 바로 쓰려면 실제 명령과 상태 변화의 관계, 접촉과 실패 조건, 예측 오차까지 확인해야 합니다.
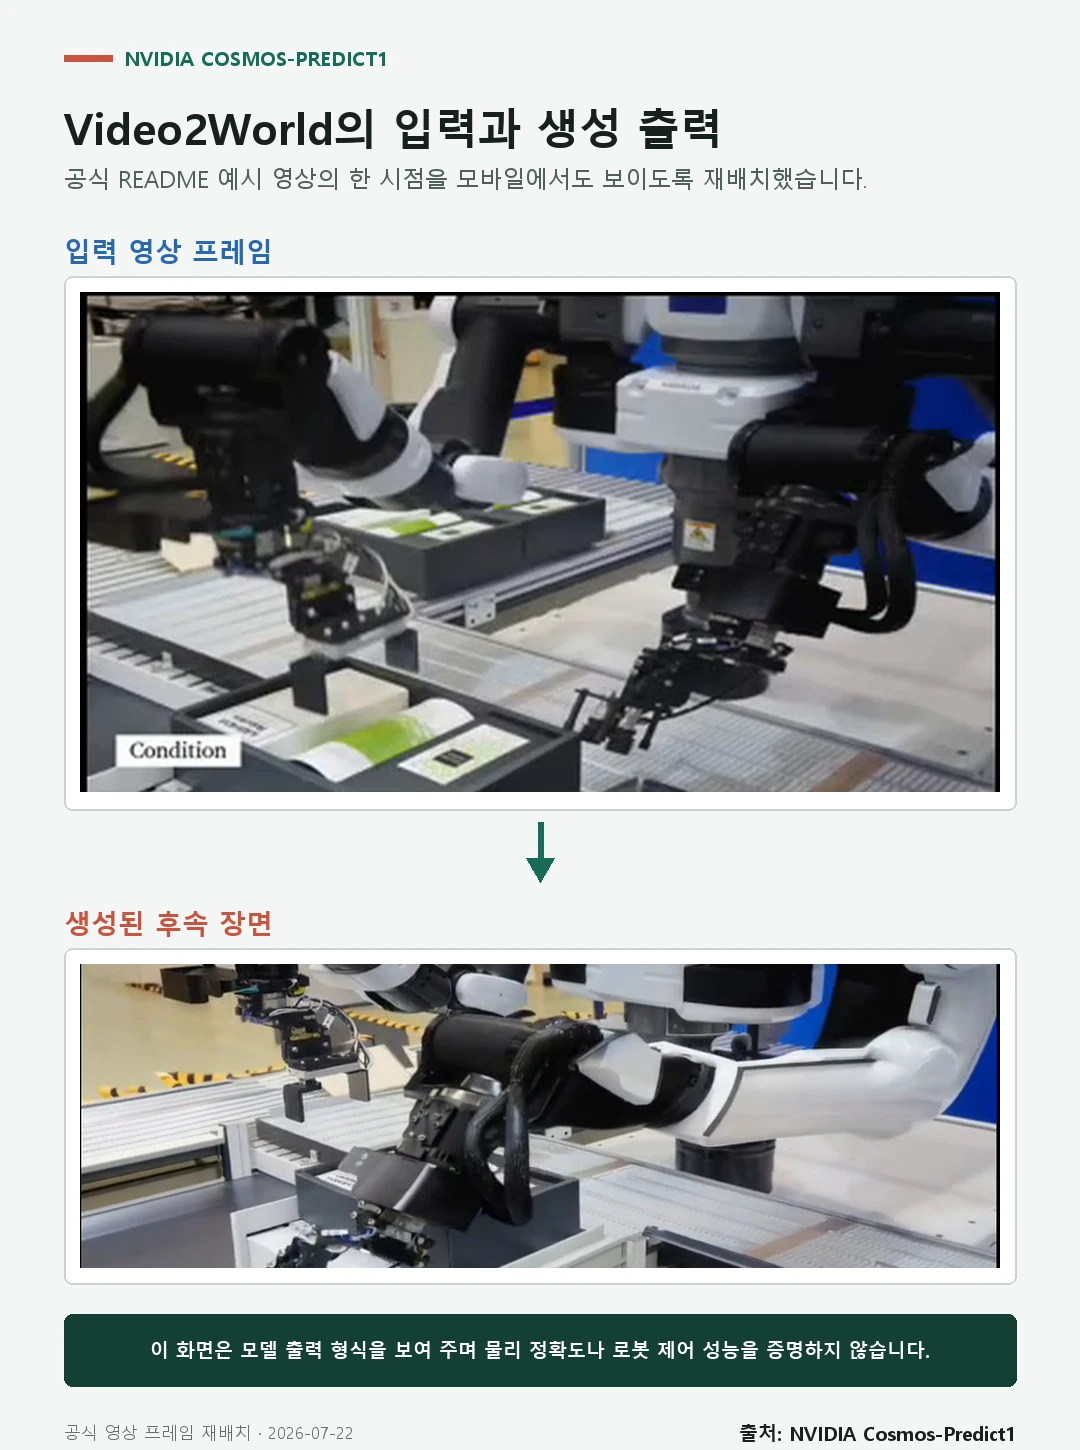
위 Cosmos-Predict1 이미지는 입력 뒤에 이어질 수 있는 장면을 영상으로 보여주는 예입니다. 이 한 장면만으로는 로봇이 낸 여러 운동 명령을 비교했는지, 물체 위치나 접촉 힘의 오차가 어느 정도인지 알 수 없습니다. 시각적으로 자연스러운 미래와 제어에 쓸 수 있도록 검증된 미래 예측은 구분해서 봐야 합니다.
예측기, 정책, 제어기는 서로 다른 일을 한다
월드 모델은 기본적으로 예측기입니다. 현재 상태와 행동 후보를 받아 다음 상태를 추정하며, 구성에 따라 보상이나 작업 종료 가능성도 함께 예측합니다. 무엇을 목표로 삼을지, 어떤 결과를 더 좋다고 볼지는 월드 모델만으로 정해지지 않습니다.
정책(policy)은 관찰이나 잠재 상태에서 행동을 고르는 규칙입니다. 월드 모델의 표현을 입력으로 쓸 수도 있고, 월드 모델이 만든 가상 경험으로 학습할 수도 있습니다. 반면 제어기(controller)는 선택한 행동을 관절이나 바퀴의 명령으로 바꾸고, 새 센서 값을 받아 오차를 줄이는 폐루프를 맡습니다. 논문이나 제품마다 정책과 제어기를 겹쳐 부르기도 있지만, 예측과 선택과 실행을 나누어 보면 구조를 오해하기 어렵습니다.
명시적인 미래 전개가 항상 필요한 것도 아닙니다. 2018년 World Models의 V–M–C 구조에서 V는 관찰을 잠재 벡터로 압축하고, M은 시간 이력과 행동으로 다음 상태를 예측하며, C는 현재 잠재 상태와 M의 은닉 상태를 받아 곧바로 행동을 냅니다. 즉 예측 모델이 배운 표현을 정책이 이용하되, 실행 시점마다 후보 미래를 따로 펼쳐 보지 않고도 움직일 수 있습니다. 이 연구의 실험 대상은 가상 게임 환경이었으며 실제 로봇 하드웨어를 검증한 결과는 아닙니다.
상자를 미는 장면으로 보면 오차까지 보인다
테이블 위 상자를 표시선까지 밀되 옆의 컵은 건드리지 않는 상황을 가정해 보겠습니다. 이것은 설명을 위한 가상 예시이지 실제 성능 실험이 아닙니다. 로봇은 최근 카메라 영상과 관절 상태, 접촉 신호를 묶어 상자와 컵의 위치, 움직임, 가려진 부분을 포함한 현재 상태를 추정합니다.
행동 후보는 정면으로 짧게 밀기, 비스듬히 밀기, 일단 멈추고 다시 관찰하기처럼 달라질 수 있습니다. 이 예시에서는 각 후보 뒤의 상자 이동 거리와 회전, 컵과의 간격, 접촉 지속 여부를 예측 대상으로 삼을 수 있습니다. 모델 예측 제어(Model Predictive Control, MPC)처럼 되먹임 구조로 설계한다면 계획기는 기대 결과가 좋은 후보를 고르고, 시스템은 짧게 실행한 뒤 관찰을 갱신합니다. 모든 정책이나 제어기가 이런 후보 비교를 하는 것은 아닙니다.
검증 가능한 지점은 예측과 실제의 차이입니다. 예상한 상자 중심 위치와 실제 위치, 회전 각도, 컵과의 간격, 접촉 신호가 어긋날 수 있습니다. 원인은 모델에 충분히 반영되지 않은 마찰이나 가림뿐 아니라 센서 보정, 상태 추정, 명령과 관측의 시점 차이일 수도 있습니다. 시스템은 이 오차를 다음 판단에 반영해 다시 계획하거나 보수적인 제어로 전환할 수 있습니다. “상자가 자연스럽게 움직이는 영상”만으로는 이런 오차를 측정할 수 없습니다.
‘상상’은 학습 중에도, 실행 직전에도 쓰인다
월드 모델로 미래를 굴린다는 말에는 서로 다른 두 방식이 섞여 있습니다. 하나는 학습할 때의 상상입니다. DreamerV3는 학습 대상 환경(시뮬레이션 포함)에서 얻은 상호작용 경험으로 환경 모델을 만들고, 그 모델 안에서 상상한 미래 시나리오로 정책을 개선합니다. 정책 업데이트에 모델 안의 궤적을 활용하는 방식이며, 그 자체가 실제 로봇 실험을 뜻하지는 않습니다.
다른 하나는 실행 시점의 온라인 계획입니다. PlaNet처럼 잠재 공간에서 여러 행동 순서를 빠르게 예측하고, 기대 결과가 좋은 순서를 찾은 다음 첫 행동을 실행할 수 있습니다. 새 관찰이 들어오면 상태를 고쳐 잡고 다시 계산합니다. 이런 반복 계획은 모델 예측 제어(Model Predictive Control, MPC)와 닮았습니다.
두 방식을 모두 써야 하는 것은 아닙니다. 월드 모델 안에서 정책을 학습한 뒤 실행 때는 정책만 빠르게 사용할 수도 있고, 학습된 예측기를 매 순간 계획에 넣을 수도 있습니다. “월드 모델을 쓴다”는 말만으로는 학습용인지 온라인 계획용인지 알 수 없으므로 시스템 구조를 함께 봐야 합니다.
한 단계 뒤를 잘 맞힌다고 긴 행동 순서까지 정확한 것은 아닙니다. 예측한 상태를 다시 입력으로 넣어 다음 상태를 계산하면 작은 위치 오차가 접촉 시점과 힘의 차이로 이어지고, 그 차이가 다음 예측에서 더 커질 수 있습니다. 학습 데이터에 없던 물체나 조명, 마찰 조건에서는 오차가 더 빨리 쌓일 수 있습니다.
그래서 긴 미래 하나를 정답처럼 믿기보다 짧게 실행하고 다시 관찰하는 폐루프가 중요합니다. 평가도 영상의 선명도만 볼 일이 아닙니다. 작업에 필요한 물체 위치, 접촉, 보상이나 종료 조건을 얼마나 오래 맞히는지, 실제 관찰이 예측과 달라졌을 때 어떻게 수정하는지를 봐야 합니다.
시뮬레이터와 월드 모델은 겹쳐 쓸 수 있다
시뮬레이터와 월드 모델을 완전히 갈라 놓을 필요는 없습니다. 전통적인 시뮬레이터는 사람이 정한 물리식, 로봇 구조, 센서 모델로 환경 변화를 계산합니다. 월드 모델은 주로 관찰과 행동 데이터에서 변화 규칙을 학습합니다. 출발점은 다르지만 둘 다 행동 뒤의 상태를 만들어 내는 데 쓰일 수 있습니다.
실제로는 혼합 구성이 가능합니다. 시뮬레이터가 만든 데이터를 월드 모델 학습에 쓰고, 학습된 모델을 시뮬레이터의 일부로 넣거나, 명시적 물리 모델로 계산하기 어려운 접촉과 시각 변화를 학습 모델이 보완할 수 있습니다. Sim2Real은 가상에서 얻은 정책이나 표현을 현실로 옮길 때 생기는 차이를 다루고, 월드 모델은 그 과정에서 상태 변화 자체를 학습하고 예측하는 한 방법입니다.
모든 로봇에 명시적 월드 모델이 필요한 것은 아니다
작업 범위가 좁고 환경이 안정적이며 충분한 시연 데이터가 있다면, 모방 학습 정책이나 반응형 제어기가 관찰에서 바로 행동을 낼 수 있습니다. 아주 빠른 제어 루프에서는 여러 후보를 생성하는 계산이 오히려 지연을 만들 수 있고, 잘 알려진 동역학은 기존 제어 모델이 더 단순하고 검증하기 쉬울 수 있습니다.
명시적 월드 모델에는 비용도 있습니다. 예측기를 학습하고 실행할 연산이 필요하며, 모델이 틀린 영역에서 계획기가 그 허점을 이용하는 행동을 고를 수도 있습니다. 반대로 실제 시행착오가 비싸고, 가림이나 긴 이력이 중요하며, 한 행동이 나중 결과를 크게 바꾸는 작업이라면 예측 모델의 가치가 커집니다. 선택 기준은 “최신 로봇인가”가 아니라 예측이 데이터 비용과 계획 품질을 실제로 개선하는가입니다.
어떤 시스템이 월드 모델을 쓴다고 할 때는 이름보다 연결 방식을 보면 됩니다. 무엇을 상태로 표현하는지, 행동이 예측 조건에 들어가는지, 예측이 정책 학습과 온라인 계획 중 어디에 쓰이는지, 실제 관찰과의 오차를 어떻게 줄이는지가 드러나야 합니다. 관련 개념은 로봇 행동 데이터, Domain randomization, VLA 뜻에서 이어서 볼 수 있습니다.
자료 확인: 2026년 9월 8일(UTC). 주요 근거는 World Models, PlaNet, DreamerV3, NVIDIA Cosmos 기술 보고서입니다. 연구 구조와 한계를 설명하기 위한 자료이며 특정 로봇의 현장 성능을 보장하지 않습니다.