A-Lab 캠페인의 시간 예산은 17일 연속 운전이었다. 그러나 의사결정 지연을 밀리초로 줄이는 제어 문제가 아니었다. 분말 계량·혼합, 상자형 전기로의 가열과 냉각, 분쇄, X선 회절 측정과 해석이 한 회차의 대부분을 차지했고, 시스템은 여러 시료를 배치 처리하며 다음 합성 경로를 골랐다. 이 사례의 속도는 모델 추론 시간보다 물리 공정과 장비 가동을 끊김 없이 엮은 데서 읽어야 한다.
2026년 저자 정정이 반영된 현재 수치는 57개 표적 중 36개 실현, 즉 63%이며 총 353개 합성 레시피다. 네 개 표적은 XRD만으로 존재를 확정하기 어려워 성공에서 빠졌다. 따라서 과거 기사나 원문 초기판의 41/58을 그대로 옮기거나 ‘새 화합물 36개 발견’이라고 쓰면 안 된다. 이 글은 수정된 원문과 정정문을 기준으로 입력–표현–결정–실행–피드백을 다시 추적한다.
사람이 정한 표적에서 자동 합성 캠페인이 시작됐다
정정이 반영된 Nature 원 논문은 A-Lab이 Materials Project와 Google DeepMind의 대규모 상안정성 계산에서 고른 공기 중 안정 후보를 대상으로 했다고 설명한다. 연구진은 전구체를 구할 수 있는 57개 표적을 제시했고, 시스템은 각 표적을 처음 시도했다. 여기서 자율성은 연구 목표를 스스로 발명했다는 뜻이 아니라 주어진 표적과 제약 안에서 레시피를 만들고 실행·판정·개선한 범위를 가리킨다.
- 입력 표적: 계산상 안정하거나 볼록껍질에 매우 가까우며 공기 중 취급 조건을 만족하는 무기 고체 후보
- 초기 지식: 문헌에서 추출한 고체상 합성 절차와 계산된 상안정성·반응 에너지
- 실행 자원: 분말 투입·혼합, 네 개 상자형 전기로, 냉각·분쇄, XRD와 시료 이송 로봇
- 성공 판정: 자동 분석 뒤 수동 재검증에서 표적상을 포함해야 설명되는 회절 패턴
- 루프 경계: 사용 가능한 전구체, 공기 분위기, 정해진 가열 방식과 레시피 후보가 허용하는 범위
‘표적 57개’와 ‘레시피 353회’를 섞지 않는다. 하나의 표적에 여러 전구체 조합과 온도 시도가 들어갔기 때문에 표적 성공률 36/57과 레시피 성공률은 다른 분모다. 원문은 353개 레시피 중 표적을 만든 비율이 30%였다고 보고한다. 낮은 회차 성공률과 높은 표적 도달률은 실패 결과를 다음 경로 선택에 재사용했다는 뜻이지, 모든 회차가 독립적 발견이었다는 뜻이 아니다.
문헌·계산·실험 결과가 서로 다른 표현으로 만났다
초기 레시피는 문헌에서 추출한 3만 건 이상의 고체상 합성 절차를 학습한 모델이 표적과 유사한 알려진 물질을 찾아 전구체를 추천하고, 별도 모델이 합성 온도를 제안하는 방식이었다. 계산 쪽에서는 표적·전구체·중간상의 에너지와 반응 구동력을 사용했다. 물리 결과는 XRD 패턴으로 들어와 가능한 상과 중량분율로 변환됐다. 텍스트, 0 K 계산, 실제 분말 회절이라는 서로 다른 표현을 한 표적 ID 아래 연결한 것이 시스템의 핵심이다.
표현 사이에는 오차가 있다. 계산 데이터베이스는 정렬된 결정구조를 나타내지만 실제 시료는 부분 무질서를 가질 수 있고, 다상 혼합물의 XRD 피크는 겹칠 수 있다. 원문은 자동 모델의 상 판정을 Rietveld 정련으로 확인했으며, 사후 수동 재분석으로 최종 36개 성공을 검증했다. 따라서 자동 분석값은 물리적 진실 그 자체가 아니라 다음 결정을 위한 확률적 표현이다.
정정 뒤 ‘new’의 뜻도 좁아졌다. 표적들은 A-Lab과 레시피 예측 플랫폼의 학습 데이터에는 새로웠지만, 같은 조성이나 가까운 조성의 과거 실험 보고가 있을 수 있었다. 플랫폼에 새롭다는 말과 과학계에 처음 보고된 물질이라는 말은 다르다.
첫 레시피가 실패하면 반응 경로를 배웠다
A-Lab은 표적과 유사한 문헌 사례에서 최대 다섯 개의 초기 전구체 조합을 제안했다. 원하는 표적이 50%를 넘는 주상으로 나오지 않으면 ARROWS라는 액티브러닝 절차가 관측된 중간상과 쌍별 반응을 기록하고, 표적 형성 구동력이 큰 대체 경로를 우선했다. 같은 불리한 중간상으로 가는 경로는 더 높은 온도에서 반복하지 않는 방식으로 후보 공간을 줄였다.
결정 모델이 문헌을 버리고 처음부터 탐색한 것은 아니다. 36개 성공 중 30개는 문헌 기반 모델이 제안한 레시피에서 얻었고, 액티브러닝은 아홉 표적에서 수율이 개선된 경로를 찾았다. 그중 여섯 표적은 초기 문헌 레시피의 수율이 0이었다. 이 구분은 ‘AI가 36개를 모두 독립 발명했다’는 해석과 ‘단순 문헌 복사였다’는 해석이 모두 부정확함을 보여 준다.
중단 규칙도 성능의 일부였다. 표적이 주상이 되거나 시스템이 사용할 수 있는 레시피를 소진할 때까지 실험했다. 다만 더 긴 가열, 중간 재분쇄, 더 넓은 전구체 선택은 당시 액티브러닝의 행동 공간 밖이었다. 알고리즘이 실패를 이해해도 장비와 프로토콜이 그 해결 행동을 실행할 수 없으면 루프는 멈춘다.
로봇은 세 작업장을 API와 시료 이송으로 묶었다
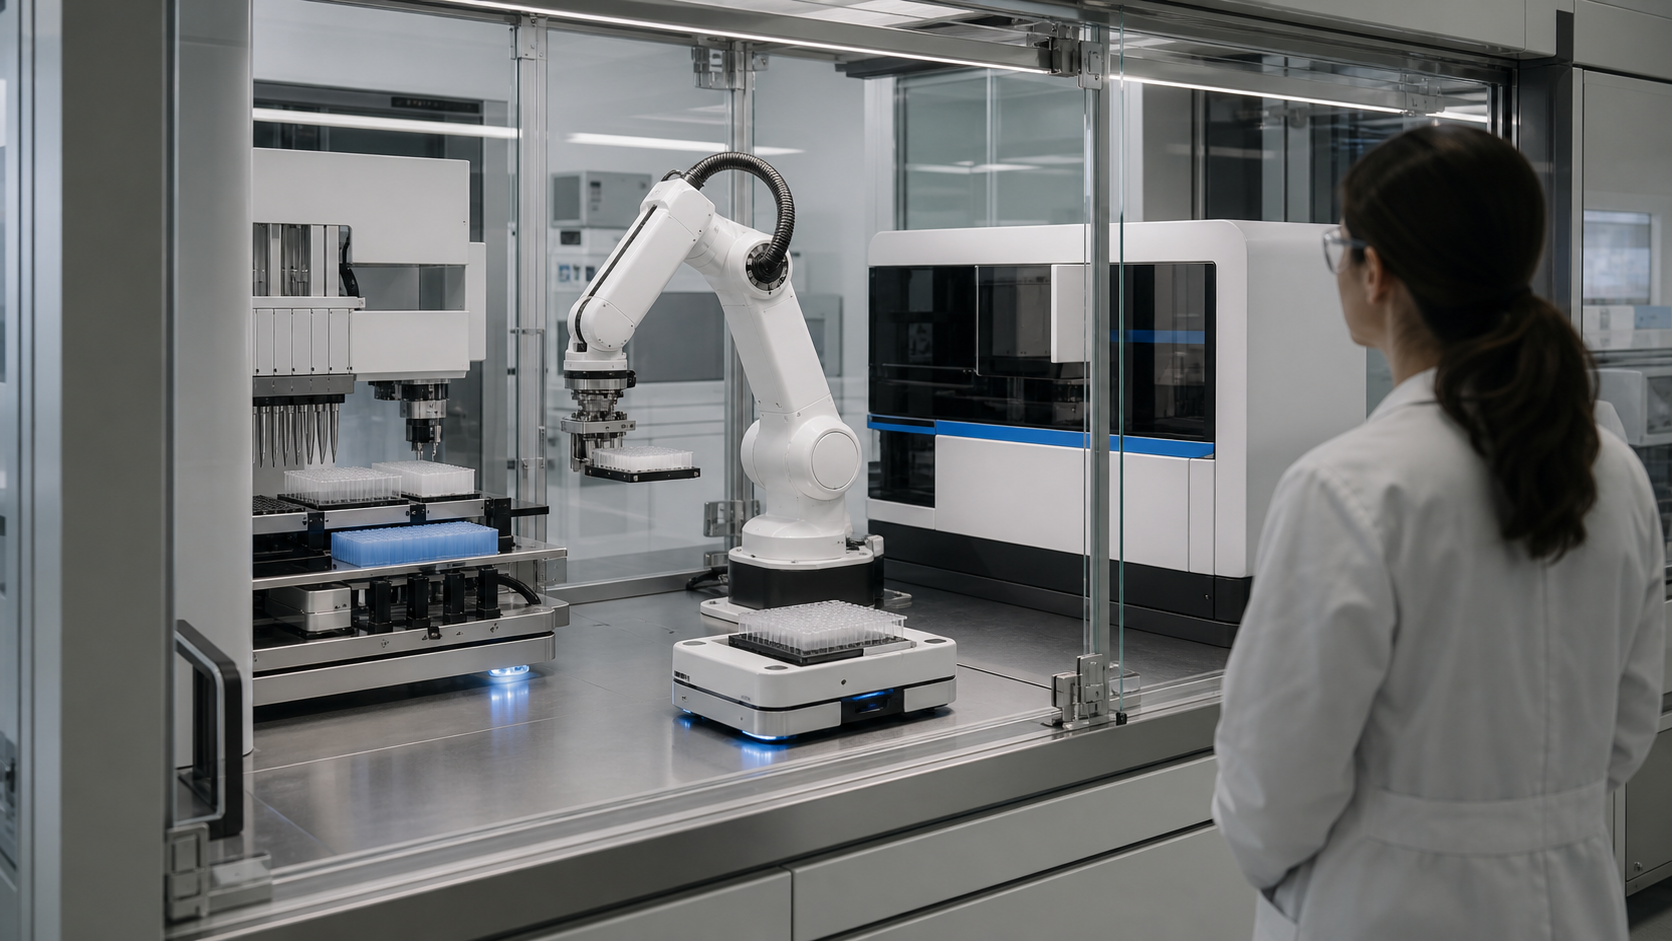
실행은 분말 계량·혼합과 도가니 적재, 전기로 가열, 냉각 뒤 분쇄와 XRD의 세 작업장으로 나뉘었다. 로봇 팔이 시료와 랙을 옮겼고 관리 서버가 작업을 제출했다. 원문은 제어 컴퓨터와 각 모듈이 로컬 네트워크로 연결되고 외부 인터넷 접근은 제어 컴퓨터로 제한됐다고 설명한다. 이는 대화형 AI가 장비를 즉석에서 움직인 장면이 아니라 정의된 작업 API를 결정 에이전트가 호출한 구조다.
이후 공개된 AlabOS 원 논문은 A-Lab의 워크플로 관리 방식을 더 자세히 보여 준다. 시료 위치와 장비 상태, 작업 순서를 데이터베이스에서 관리하고, 장비와 시료 위치를 예약한 뒤 작업을 실행하며, 방향성 비순환 그래프로 선후 관계를 보장한다. 이 논문은 17일 결과의 성공 수치를 산출한 근거가 아니라 A-Lab 계열의 실행·자원 관리 인터페이스를 이해하는 보조 1차 자료다.
물리 처리량은 배치 설계에 의존했다. 네 전기로를 활용하고 유사 온도의 시료를 함께 처리하면 한 표적의 판단을 기다리는 동안 다른 시료를 진행할 수 있다. 그래서 ‘17일’만 보고 한 회차 시간이 짧았다고 추정하면 안 된다. 캠페인 총 기간, 병렬 처리, 개별 가열 시간과 사람 개입은 서로 다른 성능 지표다.
XRD 판정이 다음 경로를 바꾸는 지점을 본다
XRD에서 얻은 상과 중량분율은 관리 서버로 돌아가 문헌 레시피를 계속할지, 액티브러닝 경로로 전환할지, 표적을 성공으로 닫을지를 결정했다. 그러나 다상 시료의 자동 해석은 모호할 수 있어 2026년 정정에서 사후 수동 재분석이 결과 수를 바꿨다. 이 사례는 피드백이 빠르기만 해서는 안 되고, 판정 불확실성이 성공·중단 규칙에 반영돼야 함을 보여 준다.
| 선택 지점 | 시스템이 본 신호 | 허용된 다음 행동 | 해석 제약 |
|---|---|---|---|
| 초기 레시피 | 표적과 문헌 물질의 유사도·추천 온도 | 전구체 조합과 한 표적 온도 선택 | 문헌에 없는 경로와 잘못된 유사도 |
| XRD 판정 | 후보 상·중량분율·정련 적합 | 성공 종료 또는 추가 실험 | 피크 중첩·부분 무질서·다상 혼합 |
| 경로 학습 | 관측 중간상과 쌍별 반응 | 불리한 경로 제외·새 전구체 우선 | 관측하지 못한 반응과 계산 에너지 오차 |
| 온도 탐색 | 낮은 온도부터 중간상 변화 | 100°C 간격 상승 | 긴 유지·재분쇄는 당시 범위 밖 |
| 캠페인 종료 | 표적 주상 또는 레시피 소진 | 표적 성공·미실현 기록 | XRD만으로 불확정이면 결론 보류 |
인수 관점에서는 자동 판정과 최종 독립 검증을 분리해야 한다. 자동 판정은 실시간 제어에 필요하고, 독립 재분석은 공개 성과의 강도를 정한다. 두 값이 다를 때 시스템을 무조건 실패로 보는 대신 어떤 패턴과 상에서 불일치가 생겼는지, 추가 분석 장비나 보수적 중단 규칙이 필요한지를 개선 자료로 사용한다.
36/57이 증명한 범위와 남은 실패는 다르다
2026년 Nature 저자 정정문은 기존에 보고한 40개 성공을 수동 재분석해 36개는 플랫폼의 결론이 맞았고 네 개는 XRD만으로 불확정이라고 밝혔다. 학습 데이터에 잘못 포함됐던 Zn2Cr3FeO8 한 개도 논의에서 제거했다. 그 결과 현재 원문은 57개 표적, 36개 성공과 63%로 갱신됐다. 과거 58개 표적·41개 성공 수치는 최신 판정이 아니다.
정정문은 원래의 물질 신규성 표현도 오해의 소지가 있었다고 인정했다. 따라서 안전한 표현은 ‘A-Lab이 처음 시도한 계산 선별 표적 36개를 실현했다’다. ‘과학에 알려지지 않은 신물질 36개를 발견했다’고 바꾸지 않는다. 네 개 불확정은 실패로 확정된 것도 아니며, 추가 분석 없이는 성공 수에 포함하지 않은 보수적 판정이다.
실현하지 못한 17개 표적은 한 원인으로 묶이지 않았다. 원문은 느린 반응속도, 전구체 휘발, 비정질화와 계산 부정확성을 큰 범주로 분류했다. 그중 11개는 낮은 구동력의 느린 반응 단계가 방해했으며, 더 높은 온도·긴 가열·향상된 혼합·중간 재분쇄 같은 당시 루프 밖 행동으로 개선 여지가 있었다. 사후 사람이 재분쇄하고 더 높은 온도로 가열해 두 표적을 추가로 만들었지만, 이는 17일 자율 캠페인의 36/57 성공 수에 더하면 안 된다.
따라서 A-Lab이 증명한 것은 제한된 무기 분말 범위에서 계산·문헌·로봇·XRD·액티브러닝을 장기간 연결해 실제 합성 결정을 반복할 수 있다는 점이다. 모든 계산 안정 물질의 합성 가능성, 완전 무인 과학자, 범용 신물질 발견률 또는 산업 스케일 생산은 이 한 연구가 증명하지 않는다. 오히려 실패 분류는 다음 세대 시스템이 행동 공간과 분석 수단을 어디까지 넓혀야 하는지 보여 준다.
A-Lab 결과가 어긋날 때 어디부터 점검하나
A-Lab의 각 장비를 연결한 단일 표준 인터페이스가 있었나요?
논문은 로컬 네트워크, 장비별 통신과 관리 API를 통해 작업을 제출한 구조를 설명하고, AlabOS는 시료·장비·작업·자원을 관리하는 소프트웨어 프레임워크를 공개한다. 그러나 이 구현이 모든 자율실험실이 따르는 국제표준이라는 뜻은 아니다. 다른 실험실은 장비 프로토콜과 시료 형식에 맞는 어댑터와 상태 계약을 별도로 검증해야 한다.
A-Lab 같은 시스템에서 성공 수가 예상과 다르면 무엇부터 확인하나요?
먼저 표적·시료 ID와 원시 XRD 파일을 맞추고, 교정·배경·피크 적합과 자동 상 판정을 독립 재분석한다. 그다음 실제 전구체·가열 이력과 문헌 레시피, 관측 중간상, 계산 안정성 순으로 본다. 측정 판정 문제와 합성 경로 실패를 분리하기 전에는 모델이나 로봇 한쪽을 원인으로 단정하지 않는다.
자료 마지막 확인: 2026년 8월 26일