컨텐츠로 건너뛰기

피지컬 AI Lab

  • 소개
  • 문의
  • 편집 원칙
  • 피지컬 AI Lab
  • 글 목록
  • 면책 안내
  • 개인정보처리방침

로봇 파운데이션 모델

VLA 모델, 로봇 파운데이션 모델, 로봇 학습 모델 정리

VLA vs VLM 차이: 로봇 행동이 붙으면 무엇이 달라질까
작성: 2026년 7월 7일 · 수정: 2026년 8월 14일 작성자: 피지컬 AI Lab
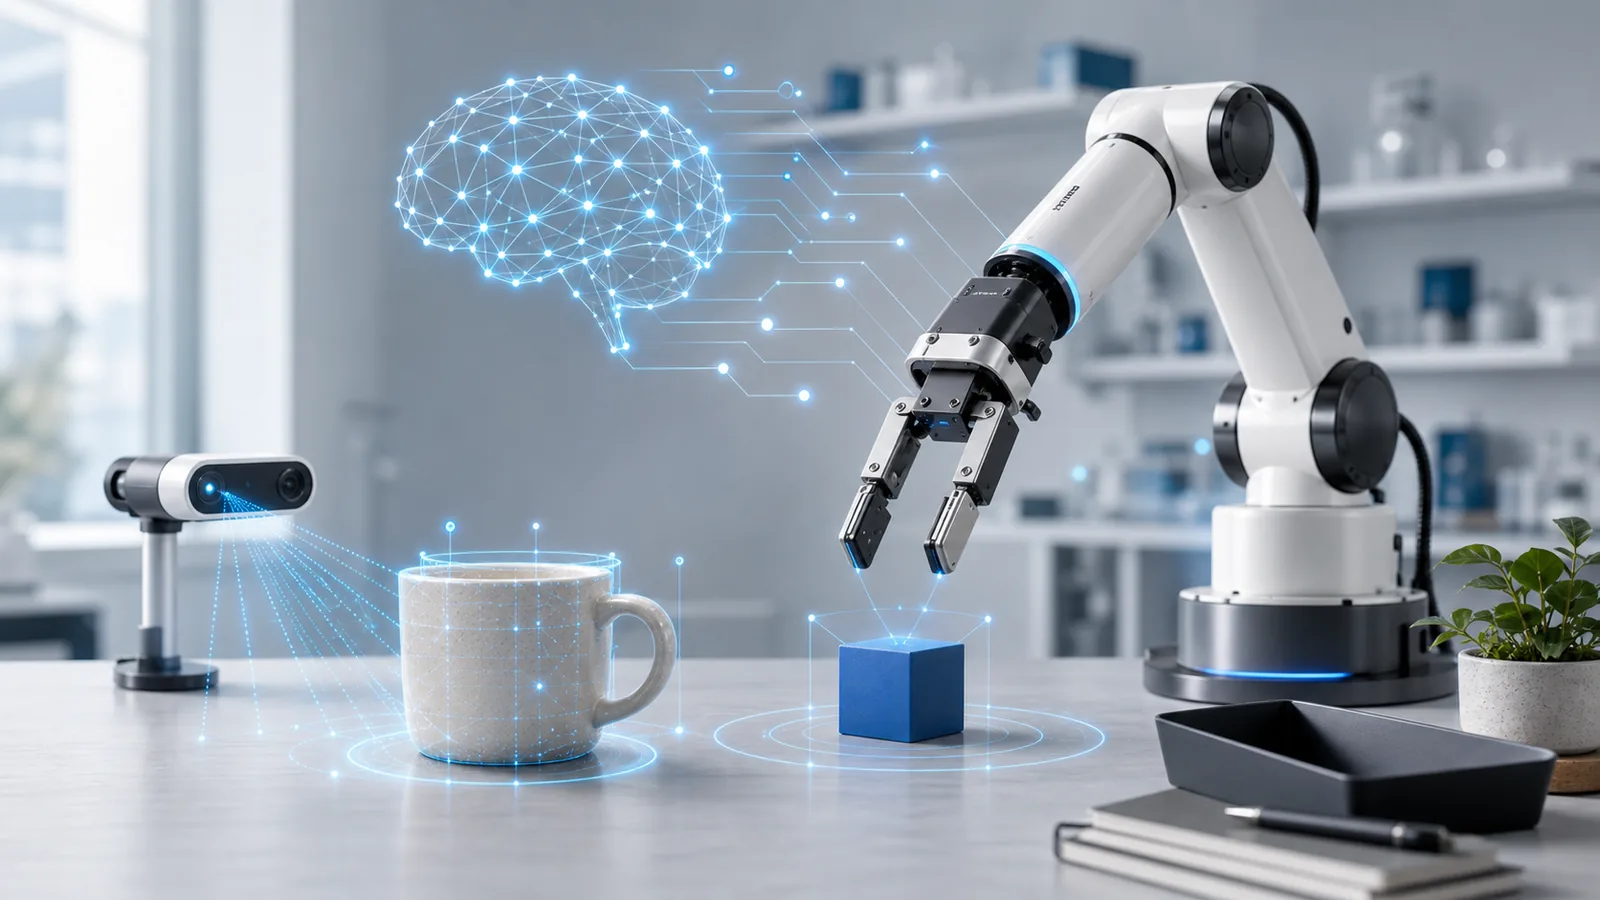
VLA와 VLM 차이를 시각, 언어, 행동 연결로 보여주는 로봇 AI 개념 이미지

VLM은 이미지와 언어를 이해하고, VLA는 그 이해를 로봇 행동으로 이어가려는 모델입니다. 두 모델의 차이를 출력, 데이터, 로봇 적용 관점에서 정리합니다.
카테고리 로봇 파운데이션 모델

로봇 파운데이션 모델 뜻: 여러 작업을 배우는 로봇 AI란 무엇인가

작성: 2026년 7월 6일 · 수정: 2026년 8월 1일 작성자: 피지컬 AI Lab
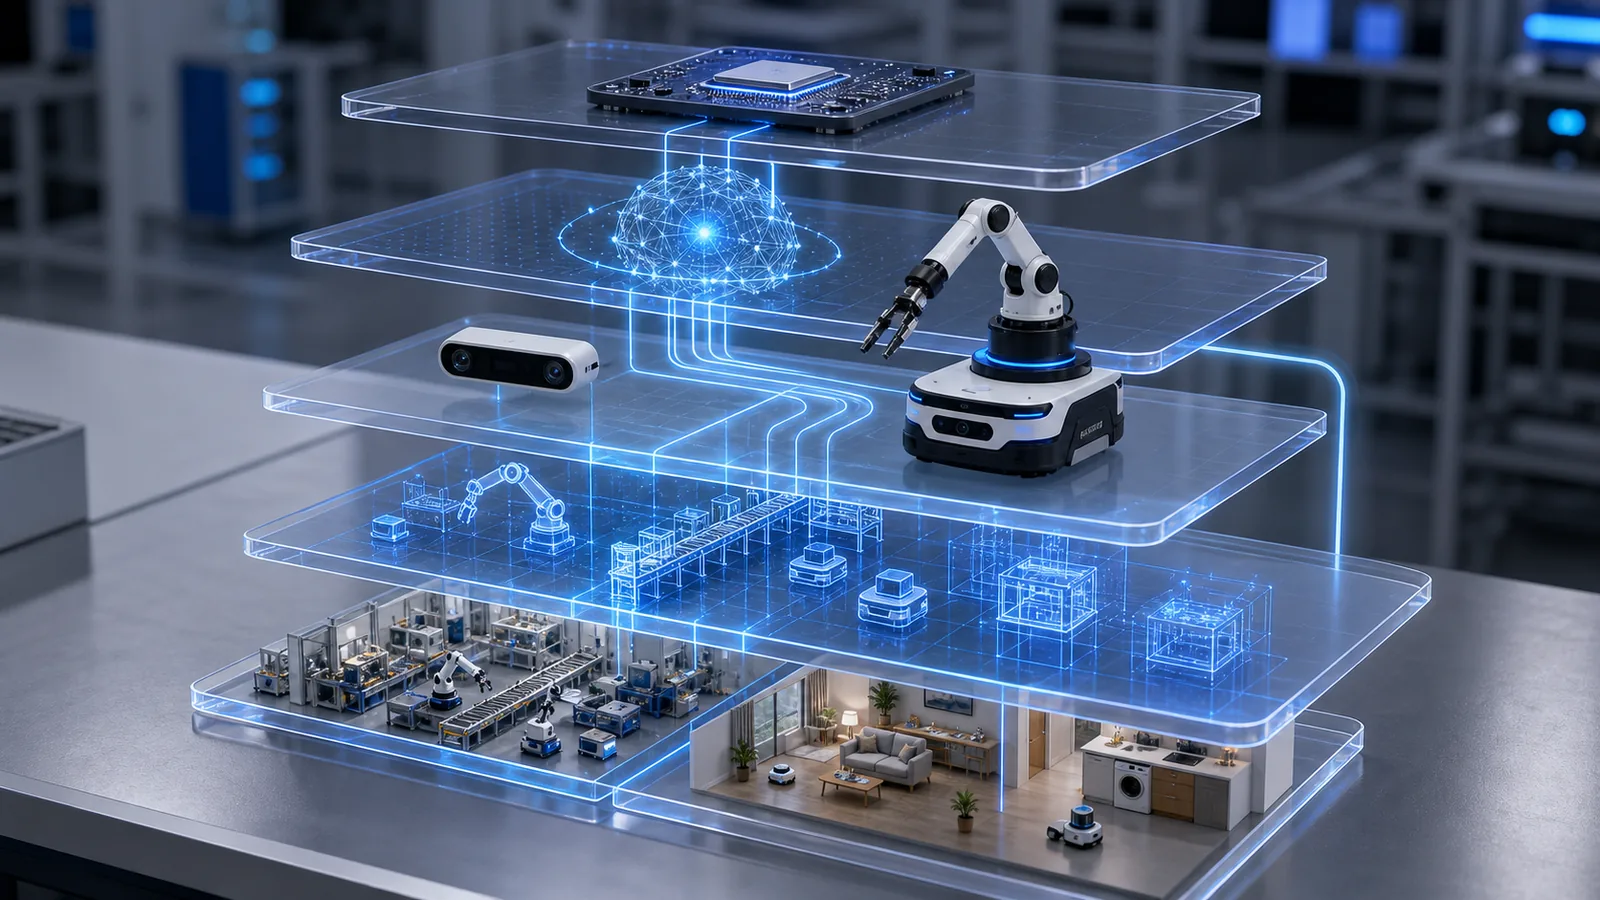
여러 로봇 작업에 공통으로 쓰이는 로봇 파운데이션 모델 개념을 보여주는 중립적인 로봇 이미지

로봇 파운데이션 모델은 여러 로봇 작업과 환경에 공통으로 쓰기 위한 기반 AI 모델입니다. LLM, VLA, 기존 로봇 프로그램과의 차이, 아직 어려운 이유를 쉽게 정리합니다.
카테고리 로봇 파운데이션 모델

VLA 뜻: 로봇이 보고 말하고 행동하는 AI란 무엇인가

작성: 2026년 7월 6일 · 수정: 2026년 9월 13일 작성자: 피지컬 AI Lab
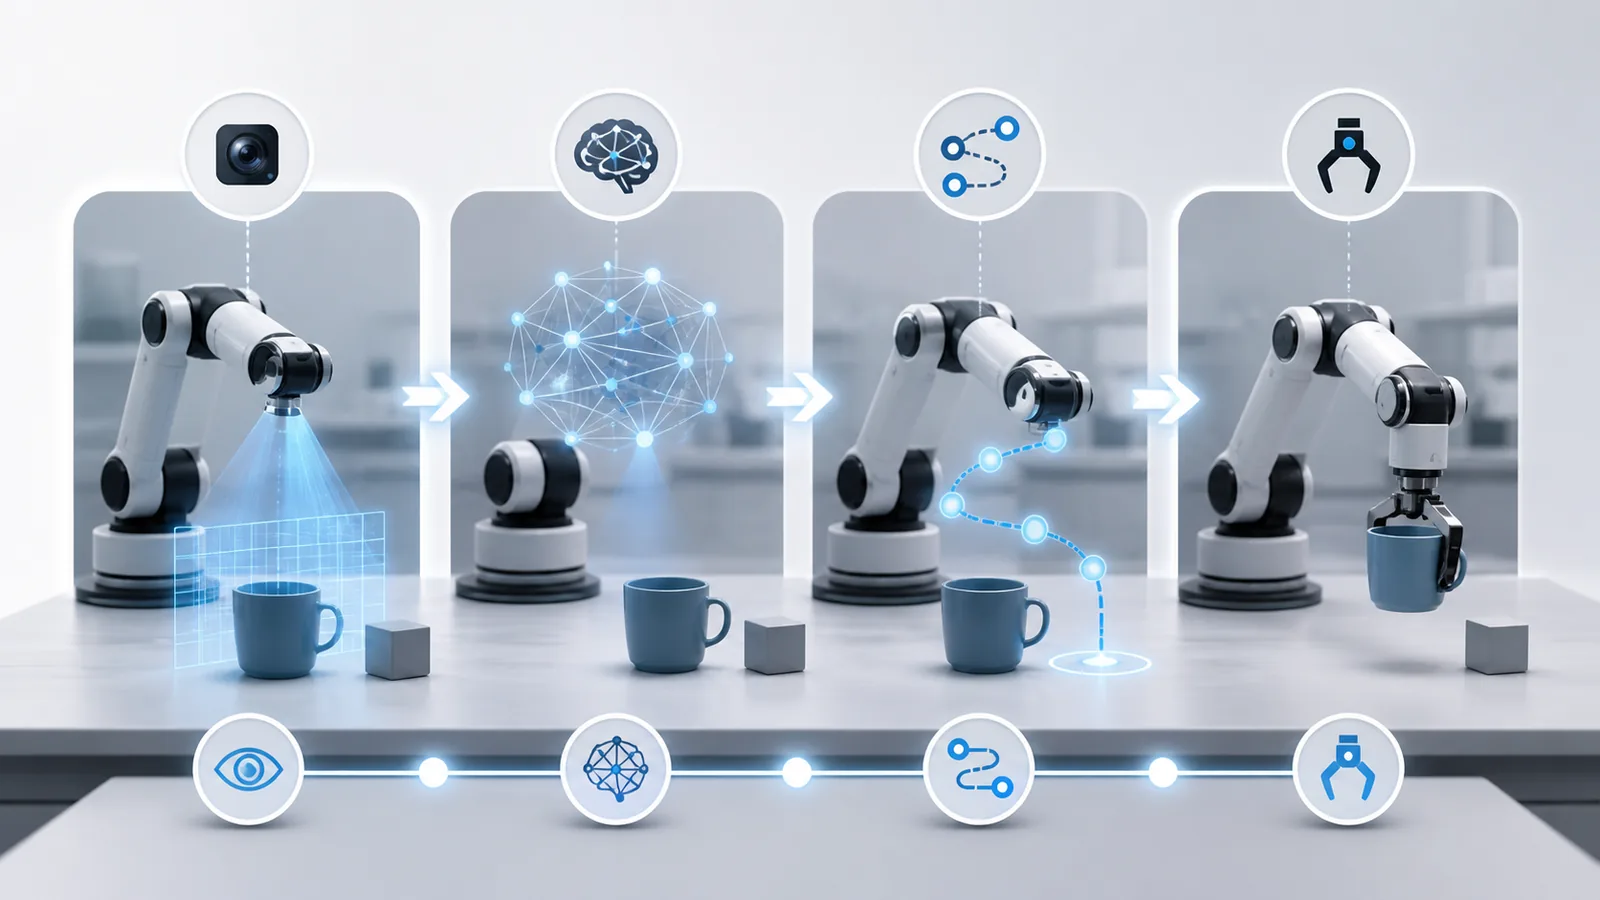
로봇 팔이 카메라로 컵을 보고 판단한 뒤 그리퍼로 집는 VLA 모델 개념 이미지

VLA는 Vision-Language-Action의 줄임말로, 로봇이 보는 정보와 언어 지시를 실제 행동으로 연결하려는 모델 흐름입니다. LLM, VLM과의 차이와 피지컬 AI에서 중요한 이유를 쉽게 정리합니다.

카테고리 로봇 파운데이션 모델
새 글
← 이전 페이지1 … 페이지3 페이지4

다른 언어로 읽기

English · 日本語 · 简体中文 · 繁體中文

주제별로 보기

  • 피지컬 AI 기초
  • 로봇 파운데이션 모델
  • 월드 모델과 시뮬레이션
  • 데이터와 하드웨어
  • 휴머노이드 로봇
  • 기업과 산업
  • 안전과 정책

전체 글 보기

사이트 안내

공식 자료를 먼저 확인하고 기술적 사실과 전망을 구분해 기록합니다.

  • 피지컬 AI Lab 소개
  • 편집 정책
  • 문의
© 2026 피지컬 AI Lab • 제작됨 GeneratePress · English · 日本語 · 简体中文 · 繁體中文